

BusinessPratique7 min de lecture (+1 technique)
Exploiter la stack LGTM à deux personnes
Mimir, Loki, Tempo et Grafana sont rarement écartés pour manque de puissance. Les petites équipes renoncent à cause de tout ce qui les entoure. Ce que coûte ce travail, comment une distribution peut le prendre en charge. Et quand choisir autre chose.
Pour : architectes · managers d’équipe · direction et DSI · ingénieurs et SREPrérequis : Aucun. Pour la partie technique, savoir ce que sont métriques, logs et traces aide.
Une entreprise industrielle de taille moyenne fait tourner une quarantaine d’applications dans son propre centre de données. Deux personnes s’occupent de la plateforme. Elles veulent voir ce qui se passe en production : combien de requêtes, combien d’erreurs, combien de temps prend chaque étape. Les données doivent rester sur le site, donc un service cloud est exclu.
Elles choisissent la stack de Grafana, souvent appelée LGTM d’après ses composants : Loki pour les logs, Grafana pour les écrans, Tempo pour les traces et Mimir pour les métriques. Un conteneur de démonstration tourne en un après-midi. Puis elles lisent qu’il est destiné au développement, aux démonstrations et aux tests. En production, il y a quatre moteurs distincts à installer, plus un collecteur et Grafana, chacun avec sa configuration, ses certificats et son cycle de mises à jour. Trois mois plus tard, elles ont des métriques, quelques logs et pas de traces. Personne n’est sûr que la prochaine mise à jour se passera bien.
Cette page explique d’où vient ce manque, ce qu’il coûte et comment le projet open source que je construis essaie de le combler.
Ce qui manque, ce n’est pas la puissance
Section intitulée « Ce qui manque, ce n’est pas la puissance »Pensez à une cuisine professionnelle. Acheter les fours est la partie facile. Ce qui prend du temps, c’est la plomberie, la ventilation, les contrôles de sécurité, le calendrier d’entretien et le fait que les plats sortent dans le bon ordre. Les moteurs de Grafana sont d’excellents fours. Les petites équipes renoncent à cause de tout ce qui les entoure.
Concrètement, une équipe qui exploite la stack à la main doit garder quatre configurations cohérentes entre elles, câbler Grafana pour qu’une métrique mène à la trace d’une requête et la trace à ses logs, mettre en place le chiffrement et la séparation entre équipes, suivre quatre cycles de mises à jour avec un retour arrière si l’une échoue, surveiller la cardinalité (le nombre de séries distinctes, qui fait grossir le stockage sans prévenir quand un label explose) et superviser l’outil de supervision lui-même. Sur beaucoup de sites industriels ou régulés, tout cela doit en plus fonctionner sans accès à Internet.
Les grandes équipes absorbent ce travail. Les petites le paient avec du temps qu’elles n’ont pas, ou choisissent un autre outil et renoncent aux traces.
À quoi ça ressemble quand ça marche
Section intitulée « À quoi ça ressemble quand ça marche »Voici ce que ces deux personnes n’ont jamais vu. Une petite boutique simulée envoie ses métriques, ses logs et ses traces. Environ 5 % des paiements échouent.
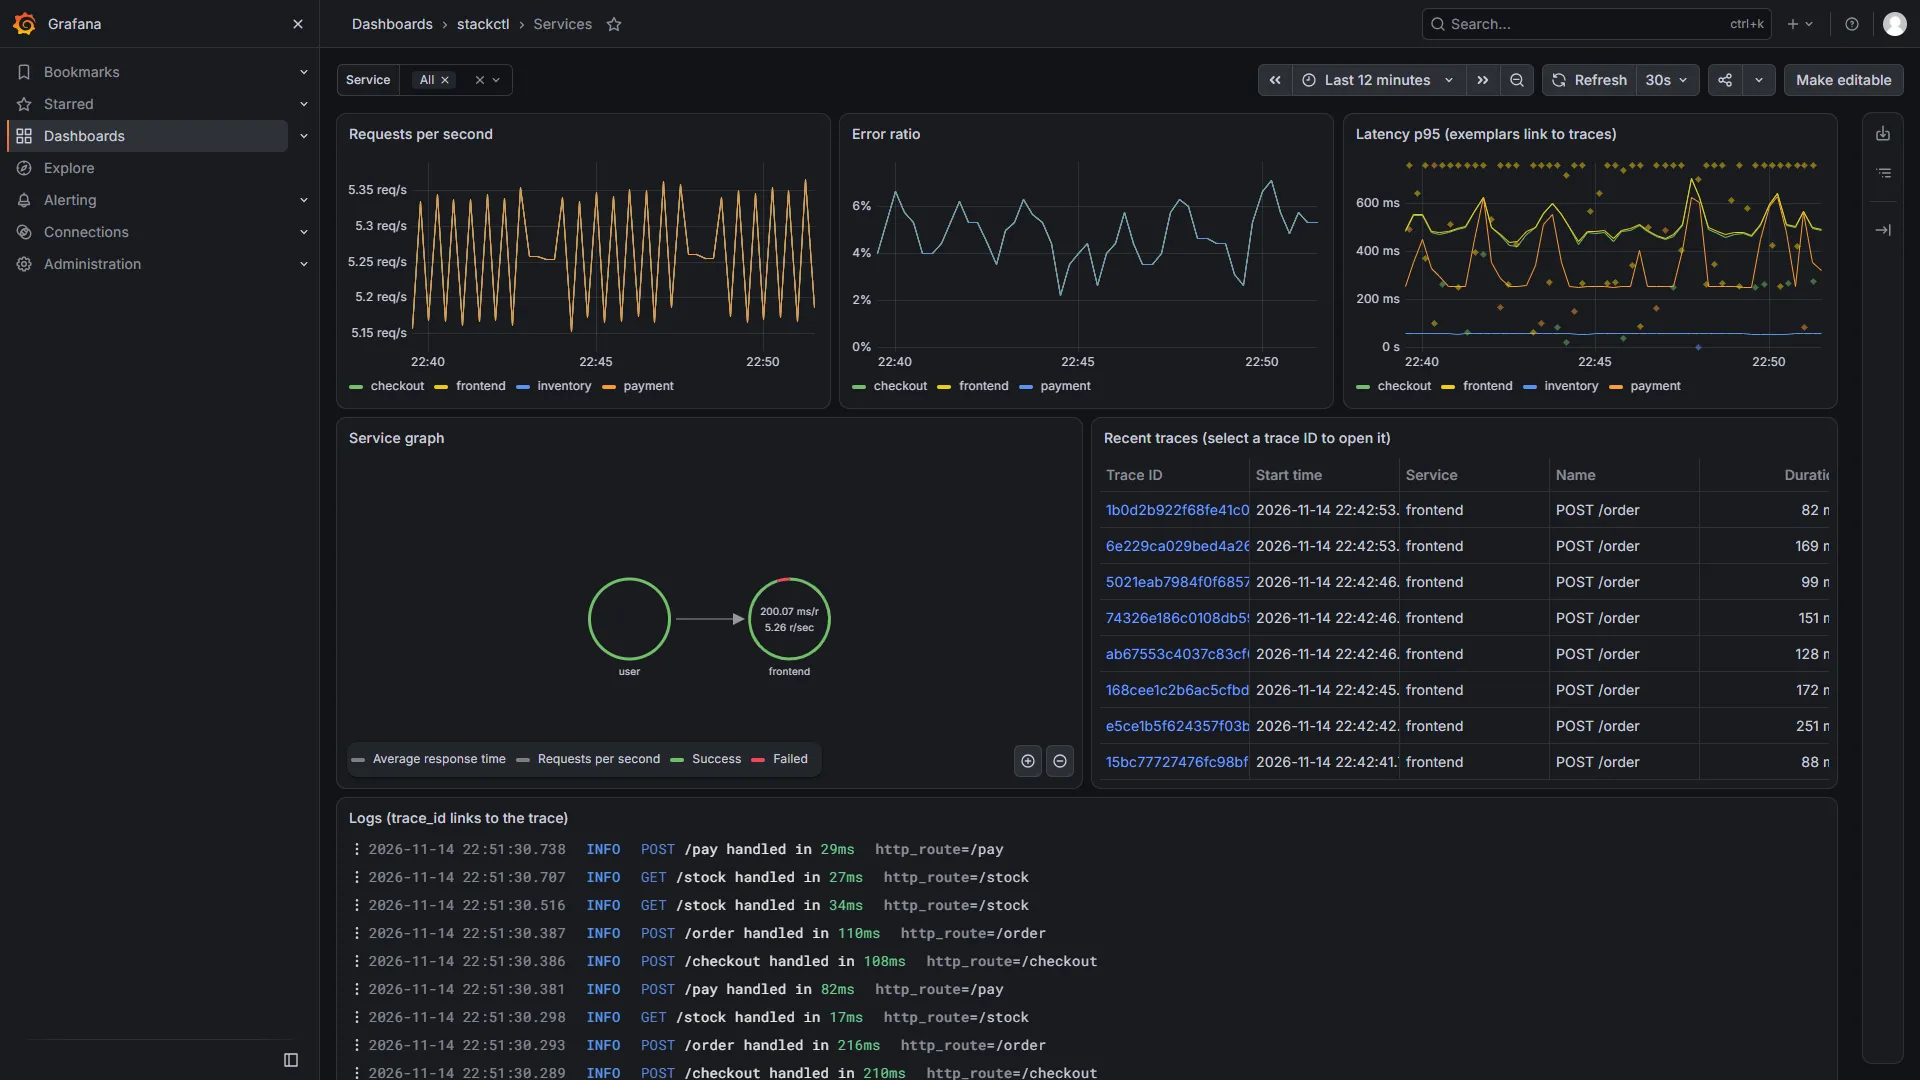
Un client écrit : « mon paiement a échoué ». Sur le tableau de bord, le taux d’erreur n’est pas nul. Chaque point du panneau de latence est une vraie requête. Un clic ouvre sa trace, le trajet de la requête à travers les quatre services. Le service de paiement y apparaît en rouge. Un second clic affiche les logs de cette requête (et seulement eux) avec le message d’erreur.
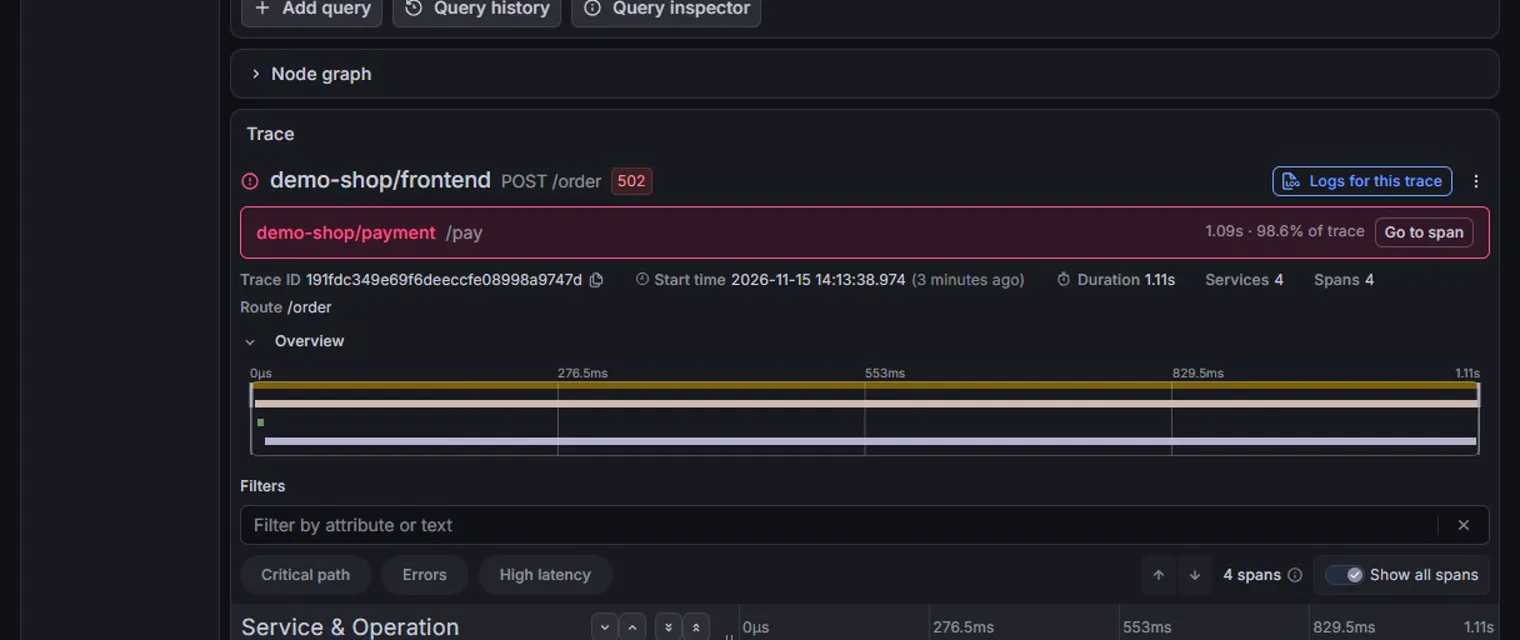
Personne n’a configuré Grafana à la main pour cela. Ce chemin du symptôme à la cause, les petites équipes ne l’atteignent généralement jamais, parce qu’il se trouve au bout de tout le travail décrit plus haut.
Faire pour LGTM ce que k3s a fait pour Kubernetes
Section intitulée « Faire pour LGTM ce que k3s a fait pour Kubernetes »Kubernetes n’est pas devenu utilisable par les petites équipes parce que quelqu’un l’a réécrit. Des distributions comme k3s l’ont emballé avec des valeurs par défaut raisonnables, une commande d’installation et un cycle de vie clair.
UniMetry, le projet open source que je construis, applique cette idée à LGTM. Un fichier de quatre lignes donne le nom du serveur. Une commande installe tout, vérifie que chaque service est en bonne santé et prépare Grafana avec ses liens et ses tableaux de bord. Sur ma machine de test, cela a pris environ une minute et demie, sans accès à Internet. La machine était généreuse : l’objectif fixé dans le cahier des charges est un tableau de bord fonctionnel en moins de quinze minutes sur un serveur modeste (4 processeurs, 8 Go de mémoire). Il n’a pas encore été mesuré.
La décision la plus importante a été de savoir quoi ne pas faire. Le raccourci tentant consiste à fusionner les moteurs en un seul programme. J’ai choisi de ne livrer que les programmes officiels, non modifiés, dans des versions testées ensemble. Les correctifs de sécurité de Grafana Labs s’appliquent directement, leur documentation reste valable. Les tableaux de bord et les alertes restent portables vers une installation plus grande ou vers Grafana Cloud. Personne n’est enfermé, y compris par ce projet.
Chaque choix structurant est écrit dans une fiche de décision d’architecture, avec les options écartées et ce que le choix coûte. Il y en a quatorze à ce jour, publiées avec le code.
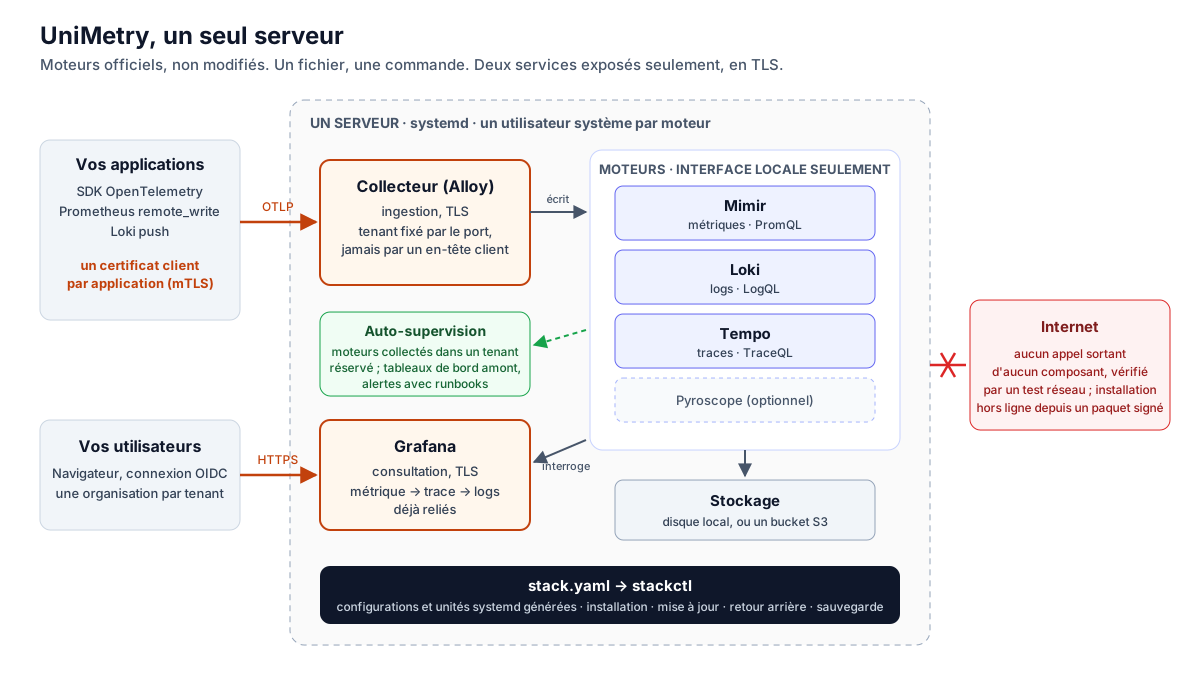
Pour les équipes techniques : l'architecture en quelques décisions
La configuration minimale :
apiVersion: v1alpha1kind: Stacknetwork: hostname: obs.example.comstackctl install la traduit en configuration native de chaque moteur (22 fichiers sur la machine de test), génère les unités systemd avec un utilisateur système par moteur, crée les autorités de certification et lance un contrôle de santé sur chaque service.
Sur un seul serveur, les moteurs n’écoutent que sur l’interface locale. Deux services sont exposés en TLS : le collecteur (Grafana Alloy) pour l’ingestion et Grafana pour la consultation. Chaque tenant a ses propres écouteurs et sa propre autorité de certification : le tenant est fixé par le port, jamais par un en-tête envoyé par le client. Le certificat d’un tenant est refusé par un autre dès la poignée de main TLS.
La stack se supervise elle-même avec les mixins de supervision amont, non modifiés, dans un tenant réservé. Le stockage est le disque local ou un bucket compatible S3. Un chart Helm couvre Kubernetes, avec une instance par moteur dans la première version.
Le dépôt compte 17 scénarios de bout en bout, dont la mise à jour et le retour arrière y compris une mise à jour en échec, la sauvegarde et la restauration après la perte de la machine, les limites de cardinalité avec des alertes à 80 %, le profilage continu avec Pyroscope, le stockage S3, le chart Kubernetes, une installation hors ligne depuis un paquet signé avec cosign ainsi qu’un test réseau qui vérifie qu’aucun composant ne fait d’appel sortant.
Où part l’argent
Section intitulée « Où part l’argent »Aucun chiffre ne serait honnête ici sans pilote, alors voici un cadre pour la discussion plutôt qu’une estimation. Quand une équipe assemble elle-même la stack, le coût se loge dans quelques endroits qui n’apparaissent sur aucune facture : les semaines d’assemblage initial, chaque mise à jour et le risque de panne qui l’accompagne, le temps perdu pendant les incidents parce que les signaux ne sont pas reliés, les problèmes sur l’outil de supervision lui-même découverts tard, le stockage qui grossit jusqu’à remplir le disque, enfin le travail de sécurité repoussé jusqu’à un audit.
La distribution prend en charge l’essentiel de ce travail : un fichier au lieu de l’assemblage, un ensemble de versions testées ensemble avec mise à jour et retour arrière en une commande, des signaux reliés dès le premier jour, une stack qui se surveille elle-même, des alertes de cardinalité avant que le disque ne soit plein, enfin le chiffrement, la séparation entre équipes et l’installation hors ligne déjà en place. Les moteurs sont open source, sans licence par serveur ni par gigaoctet.
Ce qui reste à l’équipe est réel : décider combien de temps garder les données, surveiller ce que les applications envoient, dimensionner le serveur. L’outil ne remplace pas ce jugement. Il retire la plomberie.
Quand choisir autre chose
Section intitulée « Quand choisir autre chose »Cette approche n’est pas la bonne réponse pour toutes les équipes. Si vous acceptez un service cloud et ne voulez aucune exploitation, Grafana Cloud fait tourner les mêmes moteurs pour vous, facturés à l’usage, avec vos données hébergées par un tiers. Si vous voulez l’empreinte la plus faible, des outils qui tiennent en un seul programme, comme VictoriaMetrics ou OpenObserve, sont plus légers, au prix d’autres langages de requête et de tableaux de bord à réécrire si vous les quittez un jour. Si vous exploitez Kubernetes à grande échelle avec une équipe pour s’en occuper, les charts Helm officiels vous donnent tout, y compris tout le travail décrit plus haut.
La distribution vise le cas intermédiaire : les moteurs de Grafana et leurs interfaces standard, sur votre propre infrastructure, exploités par une petite équipe.
Ce que ce n’est pas, encore
Section intitulée « Ce que ce n’est pas, encore »UniMetry est un prototype. Le périmètre mono-serveur de la première version est implémenté et testé de bout en bout et le chart Kubernetes est testé sur un cluster, mais il n’y a pas encore d’utilisateur en production. La première version n’a pas de haute disponibilité, par choix. Suivre les cycles de mises à jour de quatre moteurs représente une vraie charge de maintenance. Il y a aujourd’hui un seul mainteneur. La licence propre du projet est encore en cours de choix. Les moteurs sont sous licence AGPLv3 et le collecteur sous Apache 2.0 ; ils sont redistribués sans modification.
UniMetry est un projet indépendant, compatible avec la stack de Grafana et sans lien avec Grafana Labs.
Que faire lundi matin
Section intitulée « Que faire lundi matin »Si vous exploitez déjà la stack à la main, comptez les heures que votre équipe y a passées le trimestre dernier hors incidents : mises à jour, certificats, corrections de configuration. Ce chiffre est la référence que tout outil, celui-ci compris, doit battre.
Si vous avez renoncé aux traces, reposez la question avec la personne qui signe le budget : combien de temps a-t-il fallu pour comprendre le dernier incident sérieux ? Quelle part de ce temps a servi à chercher d’un outil à l’autre ?
Si vous voulez essayer, le dépôt contient le cahier des charges, les fiches de décision et une vidéo de démonstration de trois minutes et demie.
- Grafana Labs, image tout-en-un
grafana/otel-lgtm, décrite comme destinée au développement, aux démonstrations et aux tests : github.com/grafana/docker-otel-lgtm - Licences : Mimir, Loki, Tempo (AGPLv3), Alloy (Apache 2.0)
- UniMetry, cahier des charges, fiches de décision et tests de bout en bout : forge.erythix.tech/labstraining/unimetry/unimetry