

TechniquePratique8 min de lecture
1. Fondations
Ce qu'est l'observabilité de l'IA, pourquoi l'observabilité classique ne suffit pas, les cinq signaux, le vocabulaire de base et ce que la discipline n'est pas.
Pour : ingénieurs et SRE · architectes · métiers et produitPrérequis : Avoir une idée de ce que sont les journaux, les métriques et les traces.
Reprenons le scénario illustratif de la présentation. L’assistant de la mutuelle répond en moins de deux secondes, le taux d’erreur est nul et l’API du fournisseur renvoie 200 OK à chaque appel. Pourtant, une partie des réponses sur les remboursements est fausse. Aucun voyant ne s’allume, parce qu’aucun voyant ne mesure la justesse d’une réponse.
Ce chapitre pose les bases qui permettent de voir ce genre de problème : ce qu’on appelle observabilité de l’IA, pourquoi les outils habituels passent à côté, quels signaux collecter et quels mots employer.
1.1 Ce qu’est l’observabilité de l’IA
Section intitulée « 1.1 Ce qu’est l’observabilité de l’IA »L’observabilité de l’IA consiste à mesurer, enregistrer et interpréter le comportement des systèmes d’IA en production. Elle reprend l’observabilité classique et y ajoute des signaux propres à des systèmes qui ne répondent pas toujours la même chose et dont la matière première est du texte.
Ces signaux portent des noms qu’on retrouvera partout. Le prompt est le texte envoyé au modèle, consignes comprises. La complétion (completion) est le texte que le modèle renvoie. Un plongement (embedding) est la traduction d’un texte en une liste de nombres, de sorte que deux textes de sens proche donnent des listes proches : c’est ce qui permet de chercher des documents « par le sens ». S’y ajoutent les documents retrouvés pour répondre (le contexte de recherche), les appels d’outils et les évaluations de qualité.
La question centrale change. On ne se demande plus seulement si le système est disponible et répond dans les temps. Le système peut être disponible, rapide et faux. L’observabilité de l’IA ajoute donc un second axe : la réponse est-elle correcte, fidèle à ses sources et sans danger ?
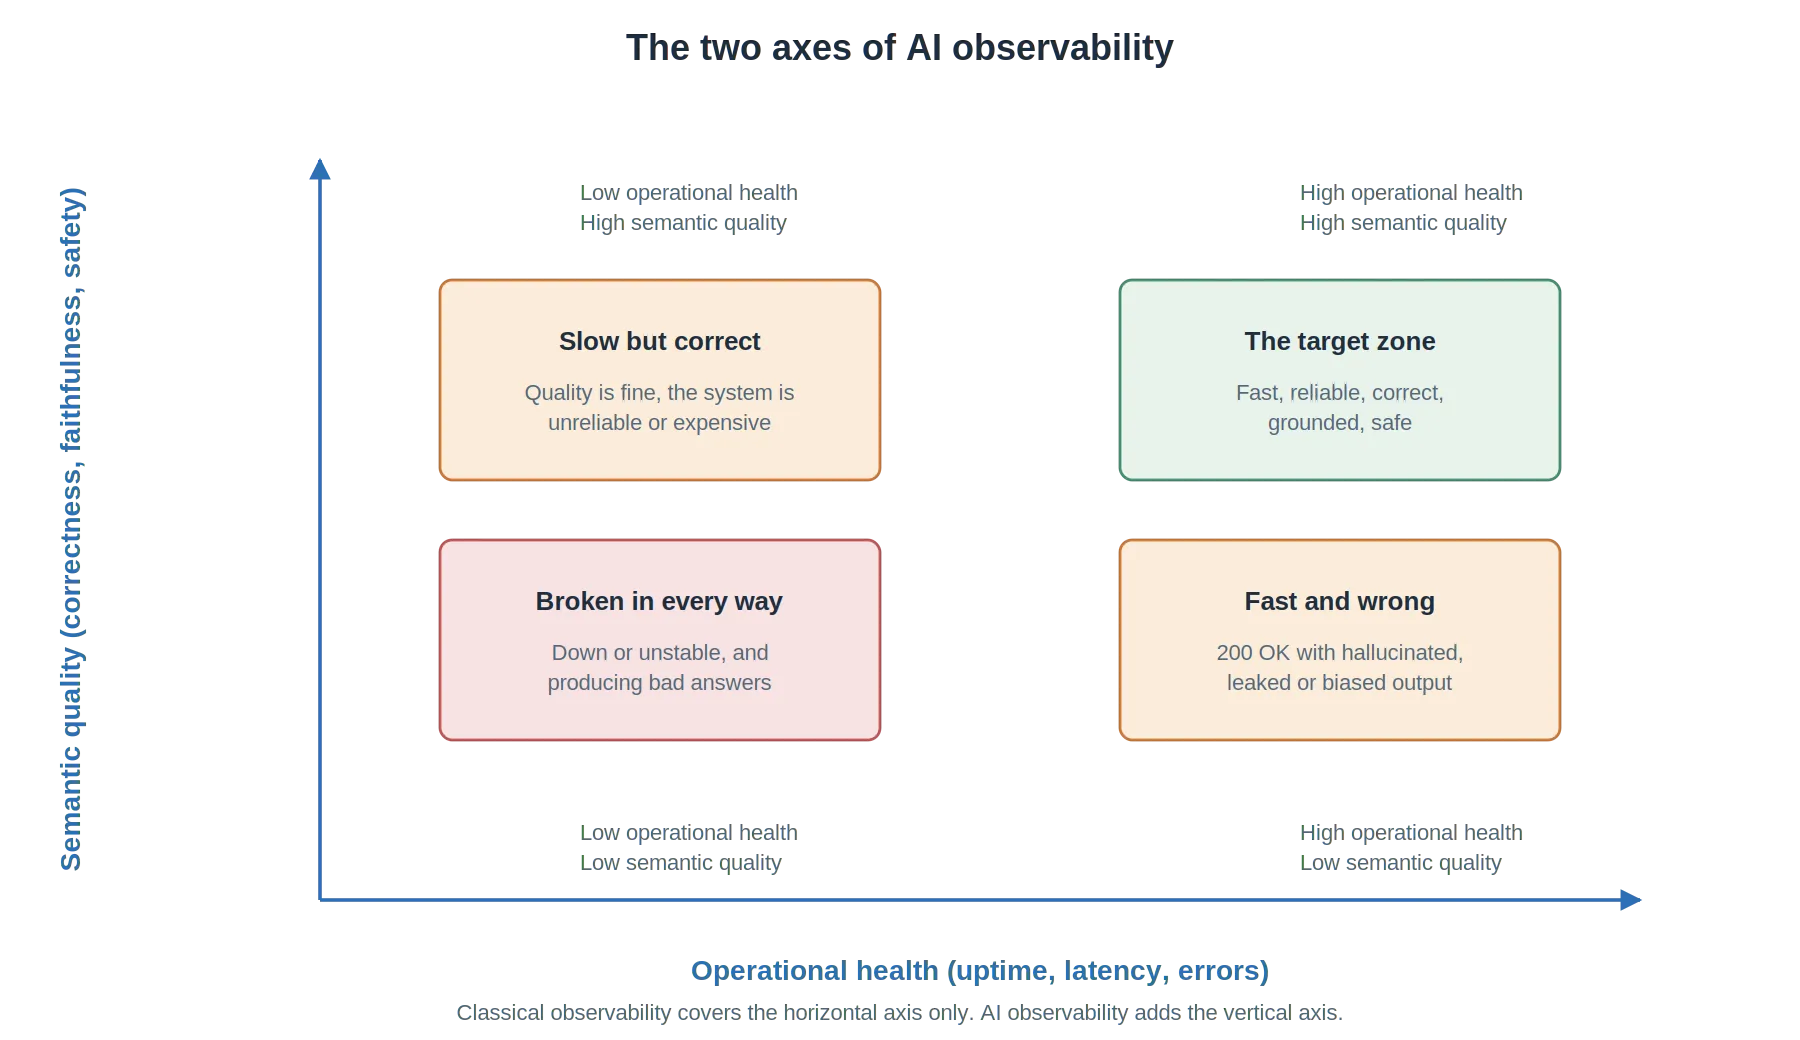
Figure 1. Les deux axes de l’observabilité de l’IA. L’observabilité classique couvre l’axe horizontal. L’observabilité de l’IA ajoute l’axe vertical.
Si votre supervision sait vous dire que le système est disponible mais pas que les réponses sont justes, vous êtes dans le quadrant inférieur droit. C’est exactement la défaillance que l’observabilité de l’IA doit empêcher. C’est celle de notre assistant.
1.2 Pourquoi l’observabilité classique ne suffit pas
Section intitulée « 1.2 Pourquoi l’observabilité classique ne suffit pas »L’observabilité classique repose sur quelques hypothèses tacites : un programme donne le même résultat pour la même entrée, ses échanges ont une forme stable, un code qui marche aujourd’hui marchera demain. Cinq propriétés des systèmes d’IA cassent ces hypothèses.
La première est le non-déterminisme. Posez deux fois la même question, vous pouvez obtenir deux réponses différentes. On ne peut donc pas supposer qu’un problème se reproduira à l’identique.
La deuxième tient à la nature des échanges. Requêtes et réponses sont du langage naturel, pas des données structurées dont le schéma ne bouge pas. Un champ JSON se valide ; une phrase, il faut la lire. La forme de la réponse, c’est la réponse elle-même.
La troisième est que la qualité se constate à l’exécution. Aucun compilateur ne garantit qu’une réponse sera juste. Un système qui a donné 100 réponses parfaites peut inventer un fait à la 101e sans que personne ait touché au code. On appelle hallucination ce genre de réponse inventée.
La quatrième est la dérive (drift). Les fournisseurs mettent à jour les poids de leurs modèles, c’est-à-dire les paramètres appris pendant l’entraînement. Les plongements se déplacent quand les documents changent. Les questions des utilisateurs évoluent. Le même code peut donc produire des réponses différentes d’une semaine à l’autre.
La cinquième est le coût variable. Les fournisseurs de modèles facturent au jeton (token), l’unité de découpage du texte, souvent un morceau de mot. Le nombre de jetons dépend de la longueur des questions et des réponses, sans plafond prévisible. Une seule boucle d’agent peut consommer le coût de milliers de requêtes normales.
Une réponse 200 OK d’un point d’accès LLM ne dit rien de la justesse de la réponse. Elle ne dit pas non plus si le modèle a halluciné, laissé fuiter des données personnelles ou produit un contenu biaisé. Ce sont pourtant les questions qui comptent pour une fonctionnalité d’IA en production.
1.3 Les cinq signaux de l’observabilité de l’IA
Section intitulée « 1.3 Les cinq signaux de l’observabilité de l’IA »L’observabilité traditionnelle compte trois signaux. Les journaux racontent ce qui s’est passé, les métriques donnent des chiffres agrégés dans le temps, les traces suivent une requête d’étape en étape, comme le suivi d’un colis. L’observabilité de l’IA en ajoute deux. Les évaluations notent la qualité d’une réponse. Les retours des utilisateurs (feedback) sont par exemple un pouce levé ou baissé. Ces deux signaux relient ce que le système a fait à ce que cela a réellement apporté.
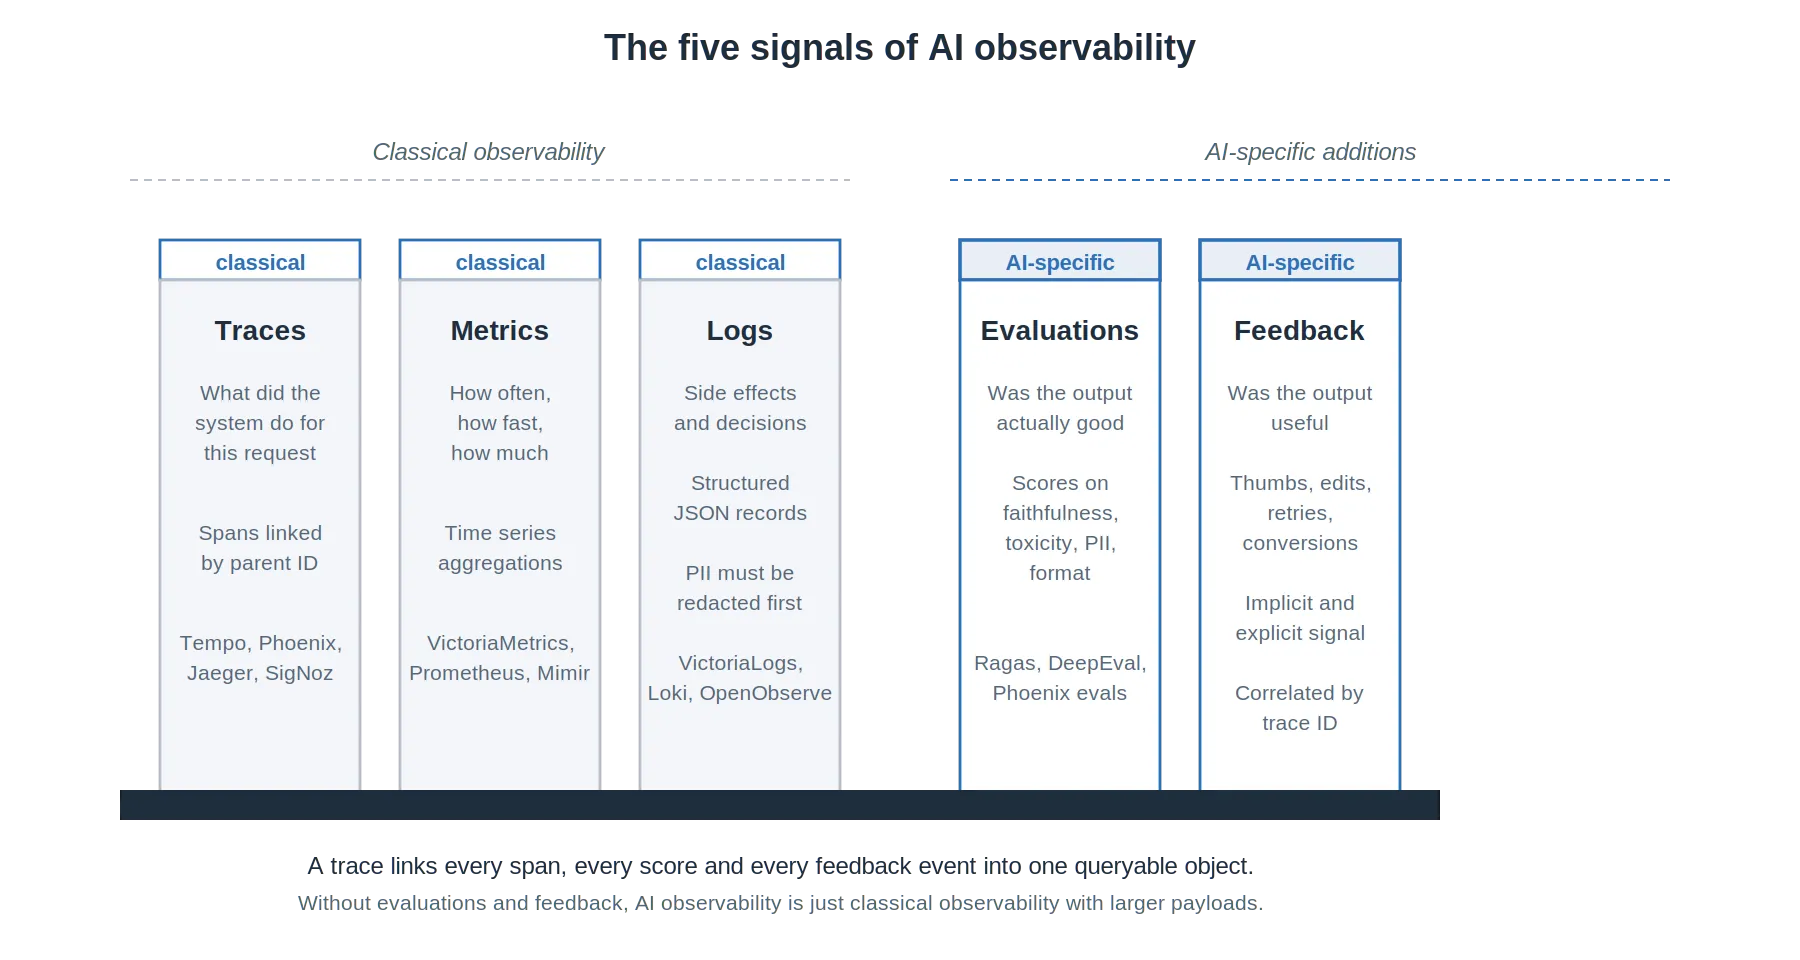
Figure 2. Les cinq signaux. L’observabilité classique fournit les trois premiers. Les évaluations et les retours utilisateurs sont les apports propres à l’IA et constituent la capacité distinctive de la discipline.
Les cinq signaux sont reliés par un identifiant unique, l’identifiant de trace (trace ID). Une trace se compose de spans : chaque span est une étape chronométrée, par exemple un appel au modèle ou une recherche de documents. Chaque span, chaque score, chaque retour utilisateur appartient à une trace. C’est ce qui permet d’interroger la plateforme de bout en bout. Sans cette clé commune, les signaux restent dans des silos qu’on ne sait pas relier.
Pour notre assistant, cela veut dire qu’un adhérent qui clique sur « pouce baissé » renvoie à une trace précise. On y retrouve la question posée, les documents retrouvés, la réponse et le score que lui a donné l’évaluateur.
1.4 Vocabulaire
Section intitulée « 1.4 Vocabulaire »Quelques termes reviennent tout au long de ce guide et dans tous les outils. Leur sens ne varie pas d’un éditeur à l’autre, je vous recommande de les employer avec précision.
| Terme | Définition |
|---|---|
| Trace | Le chemin complet d’une requête, composé de spans reliés par leurs identifiants parents. |
| Span | Une opération unique et chronométrée : un appel LLM, une recherche, une invocation d’outil. |
| Attribut | Une paire clé-valeur attachée à un span, qui sert à filtrer et à agréger. |
| Évaluation en ligne | Une notation exécutée sur les traces de production en direct, en général de façon asynchrone. |
| Évaluation hors ligne | Une notation exécutée sur un jeu de données figé, typiquement en intégration continue ou en lot planifié. |
| LLM juge (LLM-as-judge) | Une méthode d’évaluation dans laquelle un modèle note la réponse d’un autre modèle selon une grille. |
| Dérive | Un changement dans le temps des entrées, de la réalité que le système décrit ou du pipeline lui-même, qui peut dégrader les réponses. Trois familles : données, concept, pipeline (voir le glossaire). |
| Ancrage (grounding) | Le fait qu’une réponse s’appuie sur une source vérifiable plutôt que sur ce que le modèle a retenu de son entraînement. |
| Hallucination | Une réponse qui affirme des faits que ni les données d’entraînement, ni le contexte fourni, ni aucune source vérifiable ne soutiennent. |
| Fidélité (faithfulness) | Le fait qu’une réponse soit ancrée dans le contexte fourni, notée comme une qualité continue. |
| Jeu de référence (gold set) | Un jeu de questions dont la réponse idéale est connue, utilisé pour l’évaluation hors ligne. |
| Jeu de non-régression (regression set) | Un jeu de questions qui ont échoué par le passé, utilisé pour valider les changements futurs. |
1.5 Ce que l’observabilité de l’IA n’est pas
Section intitulée « 1.5 Ce que l’observabilité de l’IA n’est pas »Trois confusions reviennent souvent. Mieux vaut les lever dès le départ.
L’observabilité de l’IA n’est pas du MLOps. Le MLOps couvre l’entraînement, le conditionnement et le déploiement des modèles. L’observabilité de l’IA couvre ce qui se passe après le déploiement, quand de vraies requêtes arrivent.
Ce n’est pas non plus de la journalisation coûteuse. Enregistrer les prompts dans des journaux est un point de départ. Sans évaluation, sans détection de dérive et sans lien avec les retours des utilisateurs, les données s’accumulent et rien ne s’améliore.
Enfin, ce n’est pas un produit qu’on achète. C’est une stack qu’on assemble : instrumentation, collecte, stockage, évaluation et visualisation. À ma connaissance, aucun outil ne couvre correctement ces cinq fonctions pour les quatre types de systèmes décrits au chapitre suivant.
Pour la suite, gardez en tête l’assistant de la mutuelle : le chapitre 2 montre ce qu’il faut capturer selon qu’il s’agit d’un simple appel au modèle, d’une recherche documentaire, d’un agent ou d’un outil.
Suite : 2. Périmètre et typologie des systèmes d’IA.
Révisé le 4 octobre 2026 : les cinq signaux présentés comme le modèle de référence du site, avec la correspondance des axes des labs, des événements de contenu de la méthode et des plans de l’article.
Révisé le 25 octobre 2026 : ouverture sur un scénario illustratif, termes de base (prompt, complétion, plongement, jeton, span) expliqués, propriétés et confusions rédigées en prose.