

TechniquePratique7 min de lecture
3. La feuille de route de maturité
Six niveaux de maturité en observabilité de l'IA, de l'exploitation à l'aveugle à la boucle fermée, avec pour chacun ses signes distinctifs, ce qu'il apporte et ce qu'il demande.
Pour : ingénieurs et SRE · architectes · managers d’équipe · métiers et produitPrérequis : Avoir lu le chapitre 1 du guide.
Le jour où les plaintes sont arrivées, l’équipe de la mutuelle (toujours dans notre scénario illustratif) a voulu retrouver la réponse fautive. Elle n’a pas pu : rien n’était enregistré en dehors des codes HTTP. Elle a voulu savoir depuis quand le problème durait : aucune mesure de qualité n’existait. Elle a voulu savoir combien coûtait l’assistant : il a fallu attendre la facture du fournisseur.
Cette équipe était au niveau 0. La feuille de route qui suit décrit comment en sortir, un palier à la fois, un peu comme on apprend à conduire : d’abord savoir démarrer, puis lire les instruments, puis anticiper.
La capacité d’observabilité de l’IA progresse sur six niveaux, de 0 à 5. Chaque niveau s’appuie sur le précédent. Une fonctionnalité d’IA livrée sans stratégie d’observabilité explicite reste au niveau 0 ; un simple journal des appels la fait passer au niveau 1. À mon avis, le niveau 3 est l’objectif réaliste d’un programme de six mois. Le niveau 5 est rare : il caractérise une organisation qui fait de l’observabilité le moteur de son amélioration continue plutôt qu’une couche de supervision passive.
Cette échelle est la référence pour tous les contenus du site. La grille de maturité de la méthode GenAI et les jalons à 30, 60 et 90 jours des labs se lisent par rapport à ces niveaux.
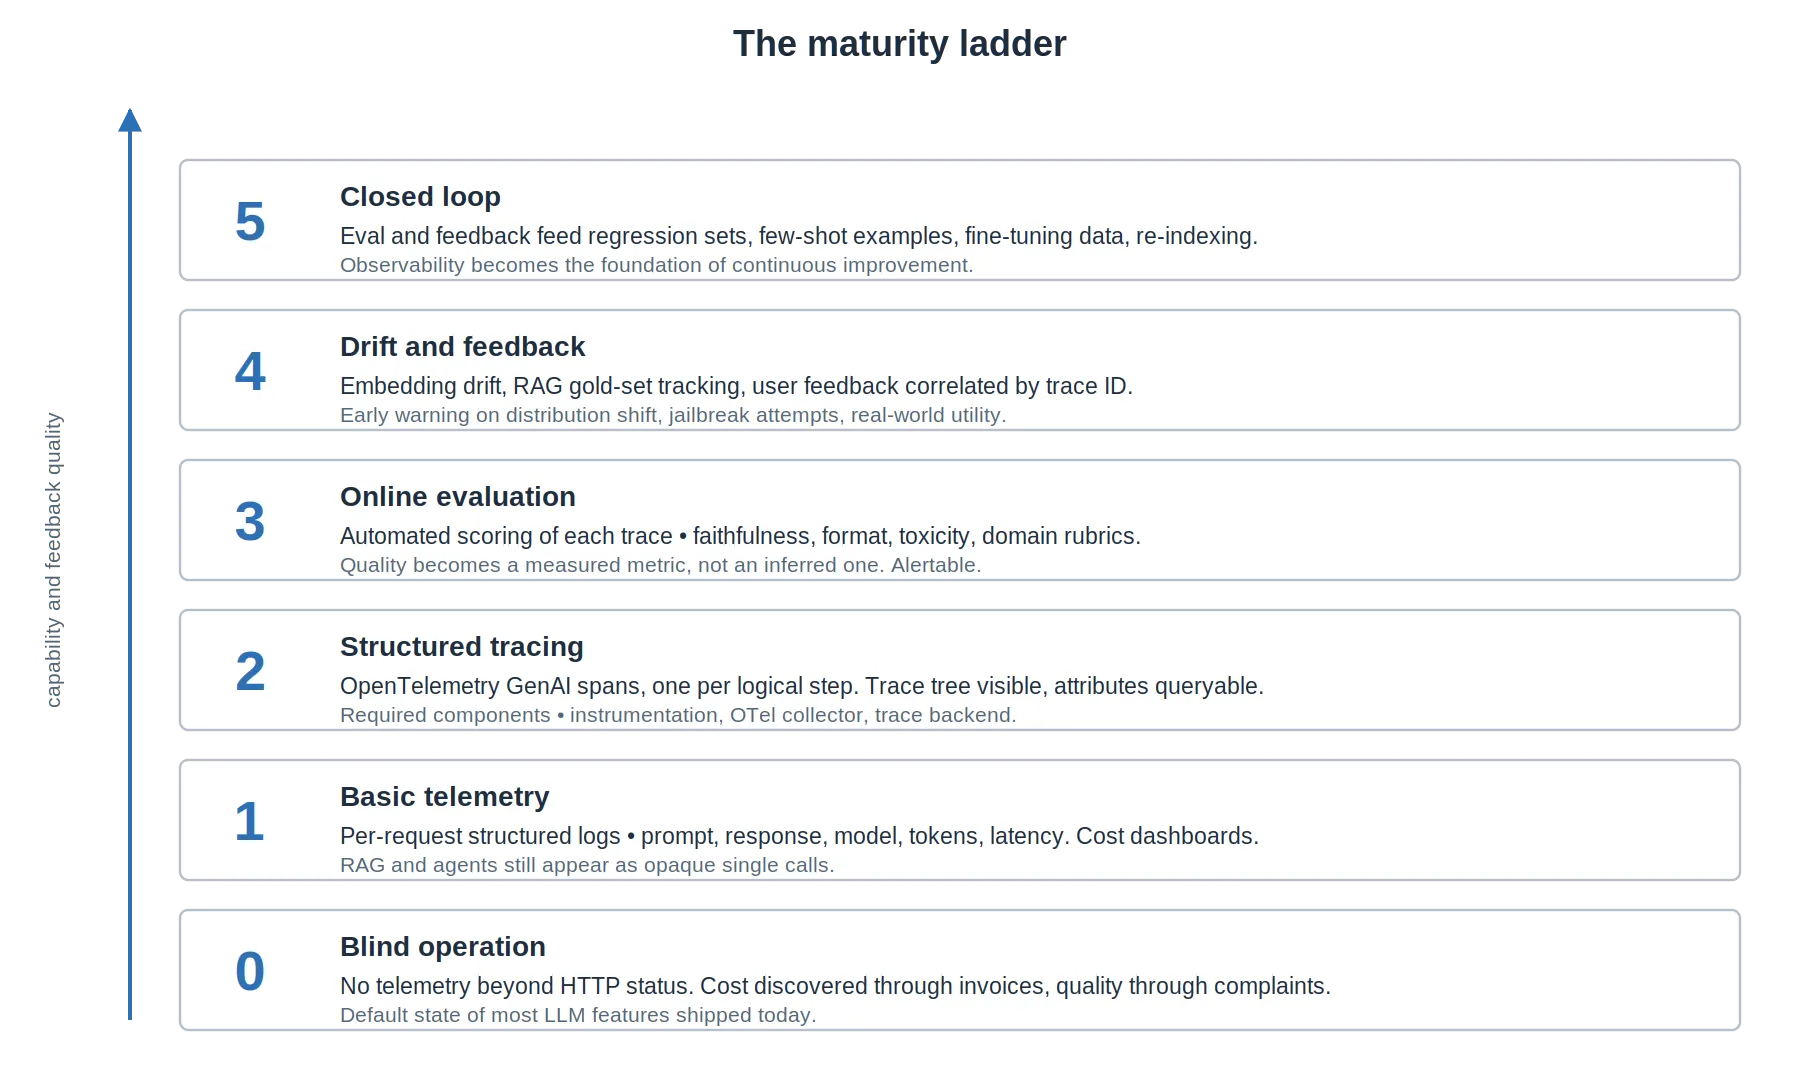
Figure 5. L’échelle de maturité, du niveau 0 (exploitation à l’aveugle) au niveau 5 (boucle fermée). Le niveau 3 est, à mon avis, un objectif réaliste à six mois.
3.1 Niveau 0 : exploitation à l’aveugle
Section intitulée « 3.1 Niveau 0 : exploitation à l’aveugle »Le système tourne en production sans autre signal que des métriques au niveau HTTP. On découvre le coût sur la facture de fin de mois et la qualité par les réclamations des utilisateurs. C’est l’état par défaut d’une fonctionnalité LLM livrée sans stratégie d’observabilité explicite.
Les signes que vous êtes au niveau 0
Section intitulée « Les signes que vous êtes au niveau 0 »Vous êtes probablement à ce niveau si vous ne savez pas dire combien de jetons ont été consommés hier, par fonctionnalité ou par locataire (un client ou une entité qui partage la plateforme). Ou si vous ne pouvez pas retrouver le prompt et la réponse liés à une réclamation précise. Autres signes : vous découvrez les hallucinations uniquement par les signalements des utilisateurs, vous n’avez aucune référence de comparaison au moment de changer de modèle et votre seule remédiation possible est le retour arrière.
3.2 Niveau 1 : signaux de base
Section intitulée « 3.2 Niveau 1 : signaux de base »Un journal structuré par requête enregistre le prompt, la réponse, l’identité du modèle, le nombre de jetons et la latence. Le coût est calculé et agrégé. Les erreurs sont suivies sous forme de métriques.
Ce que vous gagnez
Section intitulée « Ce que vous gagnez »Vous pouvez attribuer les coûts par fonctionnalité, utilisateur, locataire ou environnement. Vous pouvez fixer des budgets de latence par modèle. Après un incident, vous disposez d’un historique des requêtes passées qu’on peut interroger.
Ce qui vous manque encore
Section intitulée « Ce qui vous manque encore »Une exécution en plusieurs étapes reste opaque : un RAG ou un agent ressemble à un seul appel LLM. Vous n’avez aucun signal de qualité en dehors des retours des utilisateurs, aucune détection de dérive et aucun moyen de conditionner un changement à sa qualité.
Beaucoup d’équipes s’arrêtent ici et stagnent, parce que les journaux seuls ne produisent aucune amélioration. Le passage au niveau 2 est celui qui débloque tout le reste.
3.3 Niveau 2 : traçage structuré
Section intitulée « 3.3 Niveau 2 : traçage structuré »L’équipe adopte les conventions sémantiques OpenTelemetry GenAI. OpenTelemetry est le standard ouvert de collecte de la télémétrie ; ses conventions sémantiques fixent les noms des attributs, pour que tout le monde appelle « modèle » ou « jetons en entrée » de la même façon. Chaque requête émet un arbre de traces avec un span par étape logique. Les spans s’interrogent par leurs attributs, notamment le modèle, l’utilisateur, la fonctionnalité et le locataire.
Ce que vous gagnez
Section intitulée « Ce que vous gagnez »Les flux RAG et agents deviennent visibles sous forme d’arbres de traces. La latence se décompose étape par étape. Les attributs sont les mêmes d’un fournisseur à l’autre, ce qui évite l’enfermement propriétaire au niveau des données. Et tout cela s’intègre à l’infrastructure OpenTelemetry que vous avez peut-être déjà.
Composants nécessaires
Section intitulée « Composants nécessaires »Il faut d’abord une instrumentation compatible OTel : les SDK OTel natifs (les bibliothèques officielles à intégrer dans le code), OpenLLMetry, ou OpenInference, qui exporte au format OTLP, le protocole d’envoi d’OpenTelemetry, mais avec ses propres attributs (voir le chapitre 6). Il faut ensuite un OpenTelemetry Collector, le relais qui reçoit, transforme et achemine les données. Il faut enfin un backend de traces (trace backend), c’est-à-dire la base qui stocke et restitue les traces, comme Tempo, Phoenix, SigNoz ou Jaeger.
3.4 Niveau 3 : évaluation en ligne
Section intitulée « 3.4 Niveau 3 : évaluation en ligne »Chaque trace de production déclenche des évaluations automatiques. Leurs résultats sont rattachés comme attributs à la trace d’origine et exposés comme métriques pour l’agrégation. La qualité devient une mesure et non plus une supposition.
Évaluateurs courants à ce niveau
Section intitulée « Évaluateurs courants à ce niveau »Cinq évaluateurs reviennent souvent à ce stade. La fidélité vérifie que la réponse s’appuie sur le contexte fourni. La pertinence de la réponse vérifie qu’elle traite la question. La conformité de format vérifie que la sortie respecte le schéma attendu. La toxicité détecte un contenu nuisible. La fuite de données personnelles repère des données sensibles dans la sortie.
Ce que vous gagnez
Section intitulée « Ce que vous gagnez »Vous disposez d’un signal de qualité continu, qui ne dépend plus des retours des utilisateurs. Une baisse de qualité peut déclencher une alerte avant que les utilisateurs ne la remarquent. Et vous avez une référence pour comparer les changements de modèle et de prompt. Dans notre scénario, l’assistant de la mutuelle aurait vu sa fidélité chuter le jour de la mise à jour du contrat.
3.5 Niveau 4 : dérive et intégration des retours
Section intitulée « 3.5 Niveau 4 : dérive et intégration des retours »Le niveau 4 ajoute trois capacités à une plateforme de niveau 3.
La première est le suivi de la dérive des plongements. Rappelons qu’un plongement traduit un texte en nombres qui reflètent son sens. Si la distribution de ces nombres se déplace dans le temps, c’est que les questions ou les réponses changent de nature. On la mesure avec la divergence de Kullback-Leibler, la distance de Wasserstein ou, plus simplement, des indices de stabilité de population (PSI) : trois façons de chiffrer l’écart entre deux distributions.
La deuxième est le suivi de la qualité du RAG : on mesure en lot la précision et le rappel de la recherche par rapport à un jeu de référence entretenu.
La troisième est l’intégration des retours des utilisateurs : pouces levés ou baissés, modifications de la réponse, nouvelles tentatives, conversions, tous reliés aux identifiants de trace.
Ce que vous gagnez
Section intitulée « Ce que vous gagnez »Vous êtes prévenu tôt quand la distribution des entrées change : nouveaux usages, tentatives de contournement des garde-fous du modèle (jailbreak), changement de langue. Vous obtenez un signal fiable de l’utilité réelle, pas seulement d’une qualité mesurée par une grille. Vous avez des données pour affiner les moteurs de recherche, les modèles de reclassement et les gabarits de prompts. Surtout, vous pouvez comparer les scores automatiques à la satisfaction des utilisateurs. C’est à mon sens le signal le plus utile pour régler vos évaluateurs.
3.6 Niveau 5 : boucle fermée
Section intitulée « 3.6 Niveau 5 : boucle fermée »Au niveau 5, les évaluations et les retours alimentent le système lui-même. L’observabilité devient un moteur d’amélioration plutôt qu’un dispositif de supervision passif.
Concrètement, les traces en échec deviennent des cas de test de non-régression en intégration continue (la chaîne automatique qui teste chaque changement avant sa mise en production). Les traces de haute qualité deviennent des exemples à inclure dans le prompt (few-shot) ou des données d’affinage (fine-tuning, un réentraînement léger du modèle sur vos données). La dérive déclenche une réindexation automatique ou une nouvelle sélection de modèle. Les retours servent à entraîner des modèles de préférence ou des évaluateurs spécialisés. Et tout changement de modèle ou de prompt doit passer le jeu de non-régression.
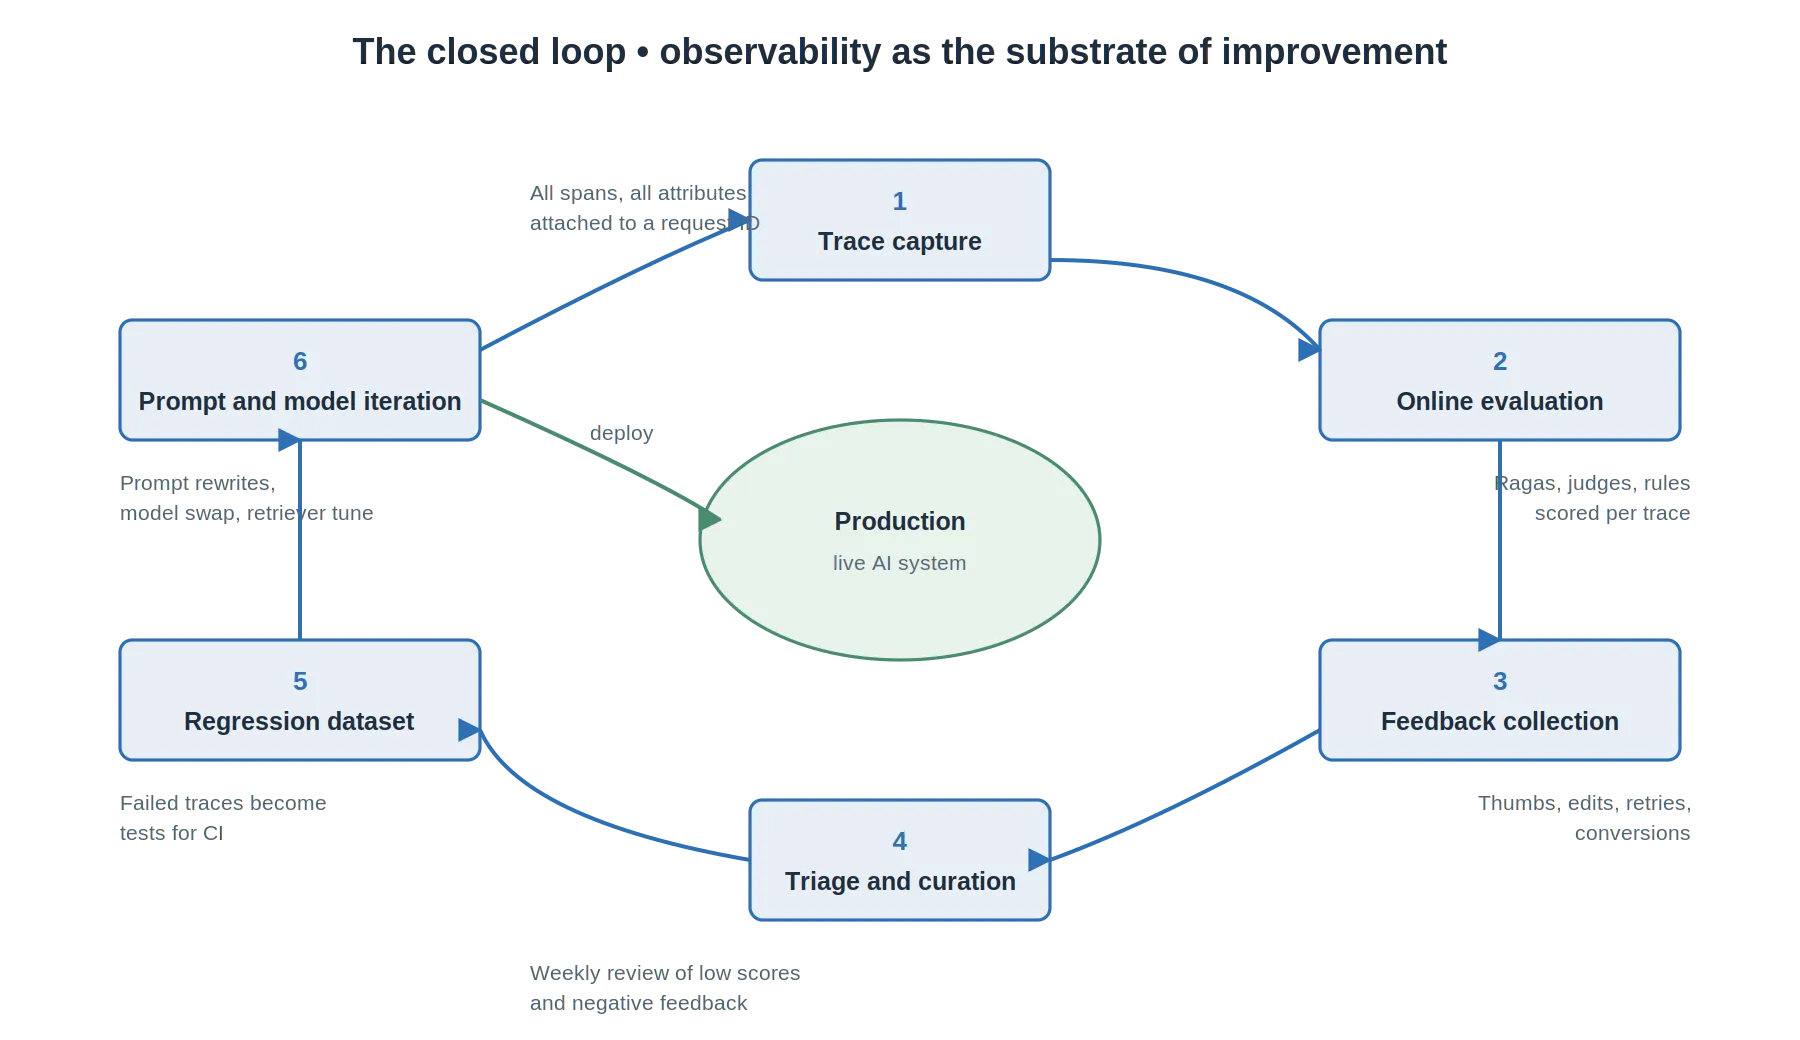
Figure 6. La boucle fermée. Les traces de production alimentent l’évaluation et les retours, qui alimentent la curation des données, qui alimente l’itération sur les prompts et les modèles, laquelle est redéployée en production.
Pour savoir quoi faire dès maintenant selon votre niveau, l’annexe propose une prochaine étape et un délai pour chacun. Le chapitre suivant détaille comment monter jusqu’au niveau 3.
Suite : 4. La mise en œuvre en sept étapes.
Révisé le 4 octobre 2026 : échelle de 0 à 5 présentée comme la référence du site, avec renvoi vers la méthode et les labs.
Révisé le 25 octobre 2026 : ouverture sur le scénario illustratif, termes expliqués (OTLP, backend, PSI, few-shot, affinage), listes rédigées en prose, renvoi à l’annexe pour les prochaines étapes.