

TechniquePratique10 min de lecture
6. Le paysage des outils
Le paysage des outils d'observabilité de l'IA par catégorie, les critères pour choisir entre auto-hébergement et service géré et deux stacks de référence à adapter.
Pour : ingénieurs et SRE · architectesPrérequis : Avoir lu le chapitre 4 du guide.
Scénario illustratif. L’équipe de la mutuelle a ses questions et sait ce qu’elle veut instrumenter. Reste à choisir les outils. Un éditeur propose une démonstration séduisante, une collègue suggère de tout installer soi-même et le responsable sécurité demande où seront stockés les prompts, qui contiennent des données d’adhérents. Trois conversations, trois critères différents.
Ce chapitre aide à trancher. Il est la référence du site pour le paysage des outils et pour les licences (section 6.4) ; les autres contenus y renvoient.
L’écosystème de l’observabilité de l’IA est dense et bouge vite. Le tableau ci-dessous classe des options répandues par catégorie et par mode d’hébergement, par ordre alphabétique. Deux modes coexistent. Les logiciels auto-hébergeables, vous les installez et les faites tourner sur vos propres machines ou votre nuage. Les services gérés (SaaS), l’éditeur les fait tourner pour vous. Figurer dans le tableau ne vaut pas recommandation : le choix dépend des contraintes propres à chaque déploiement.
| Catégorie | Logiciels auto-hébergeables | Services gérés (SaaS) |
|---|---|---|
| Instrumentation | OpenInference (Arize), OpenLLMetry (Traceloop), SDK OpenTelemetry GenAI | SDK des éditeurs (Arize, Datadog, New Relic) |
| Backend de traces | Grafana Tempo, Jaeger, Langfuse, OpenObserve, Phoenix, SigNoz | Arize AX, Datadog LLM Observability, Langfuse Cloud, New Relic AI Monitoring |
| Backend de métriques | Grafana Mimir, Prometheus, Thanos, VictoriaMetrics | Chronosphere, Datadog, Grafana Cloud, New Relic |
| Backend de journaux | Elasticsearch, Grafana Loki, OpenObserve, VictoriaLogs | Datadog, Elastic Cloud, Grafana Cloud, Splunk |
| Cadre d’évaluation | DeepEval, OpenAI Evals, Phoenix evals, promptfoo, Ragas | Arize, Braintrust, Galileo, Patronus AI |
| Dérive et plongements | Evidently, NannyML, Phoenix, WhyLabs | Arize, Fiddler |
| Visualisation | Apache Superset, Grafana, Perses, interface Phoenix | Tableaux de bord Datadog, Grafana Cloud, New Relic |
| Gestion des prompts | Langfuse, Phoenix | Langfuse Cloud, PromptLayer, Vellum |
6.1 Choisir entre auto-hébergement et service géré
Section intitulée « 6.1 Choisir entre auto-hébergement et service géré »Le choix ressemble à celui entre acheter une maison et louer un appartement meublé. Dans le premier cas, vous maîtrisez tout mais vous faites l’entretien. Dans le second, vous emménagez vite mais vous acceptez les règles du propriétaire. Trois facteurs dominent la décision.
Souveraineté des données
Section intitulée « Souveraineté des données »Les secteurs régulés (banque, défense, santé, secteur public) demandent souvent un déploiement sur site ou dans un nuage souverain. Ni NIS2 (la directive européenne sur la cybersécurité) ni DORA (le règlement européen sur la résilience numérique du secteur financier) n’imposent en eux-mêmes que le backend d’observabilité réside dans une juridiction donnée. Cette exigence peut en revanche venir d’une politique interne, d’un régulateur sectoriel ou d’un contrat.
DORA impose aux entités financières de gérer le risque lié aux prestataires tiers de services TIC (technologies de l’information et de la communication). Il leur impose aussi de tenir un registre d’information qui recense notamment les pays de stockage et de traitement des données (règlement d’exécution (UE) 2024/2956). Un backend d’observabilité qui stocke des prompts y figure comme les autres services. Quand une contrainte de localisation s’applique, le choix se réduit aux logiciels auto-hébergés ou aux éditeurs disposant de régions conformes ; les pistes d’audit doivent alors couvrir l’accès aux prompts stockés.
L’observabilité LLM commerciale se facture au span, au jeton ou à l’utilisateur. À un volume de production significatif, son coût peut rivaliser avec celui des appels LLM eux-mêmes.
Un ordre de grandeur aide à s’en rendre compte. 100 spans par requête à 1 000 requêtes par seconde en continu donnent 8,64 milliards de spans par jour, soit environ 3 150 milliards de spans par an, pour le seul traçage. Multipliez ce volume par le prix par span (ou par million de spans) de votre fournisseur. Les prix changent vite et varient selon les contrats, ce guide n’en donne donc pas : utilisez la grille datée de votre fournisseur.
L’auto-hébergement n’est pas gratuit pour autant. Il déplace le coût vers l’infrastructure et le temps d’exploitation, qu’il faut chiffrer avec la même rigueur.
Intégration
Section intitulée « Intégration »La stack d’observabilité existante dicte souvent le choix pour l’IA. Un site qui exploite déjà Grafana, Prometheus et Tempo peut garder ses backends et ajouter une instrumentation GenAI ainsi qu’un outil d’exploration propre à l’IA (Phoenix, Langfuse ou équivalent). Un site déjà équipé de Datadog ou de New Relic peut activer le module LLM de son éditeur.
Chaque outil supplémentaire alourdit l’exploitation : un logiciel à maintenir, un modèle de données, des droits d’accès. Je recommande d’en ajouter un seulement quand il répond à une question que la stack en place ne sait pas traiter et de garder l’OpenTelemetry Collector comme point d’entrée commun.
6.2 Une stack auto-hébergée de référence
Section intitulée « 6.2 Une stack auto-hébergée de référence »Voici la stack que je recommande comme point de départ pour des déploiements européens soumis à des exigences de souveraineté. C’est une proposition à adapter : chaque couche se remplace et d’autres combinaisons répondent aux mêmes critères.
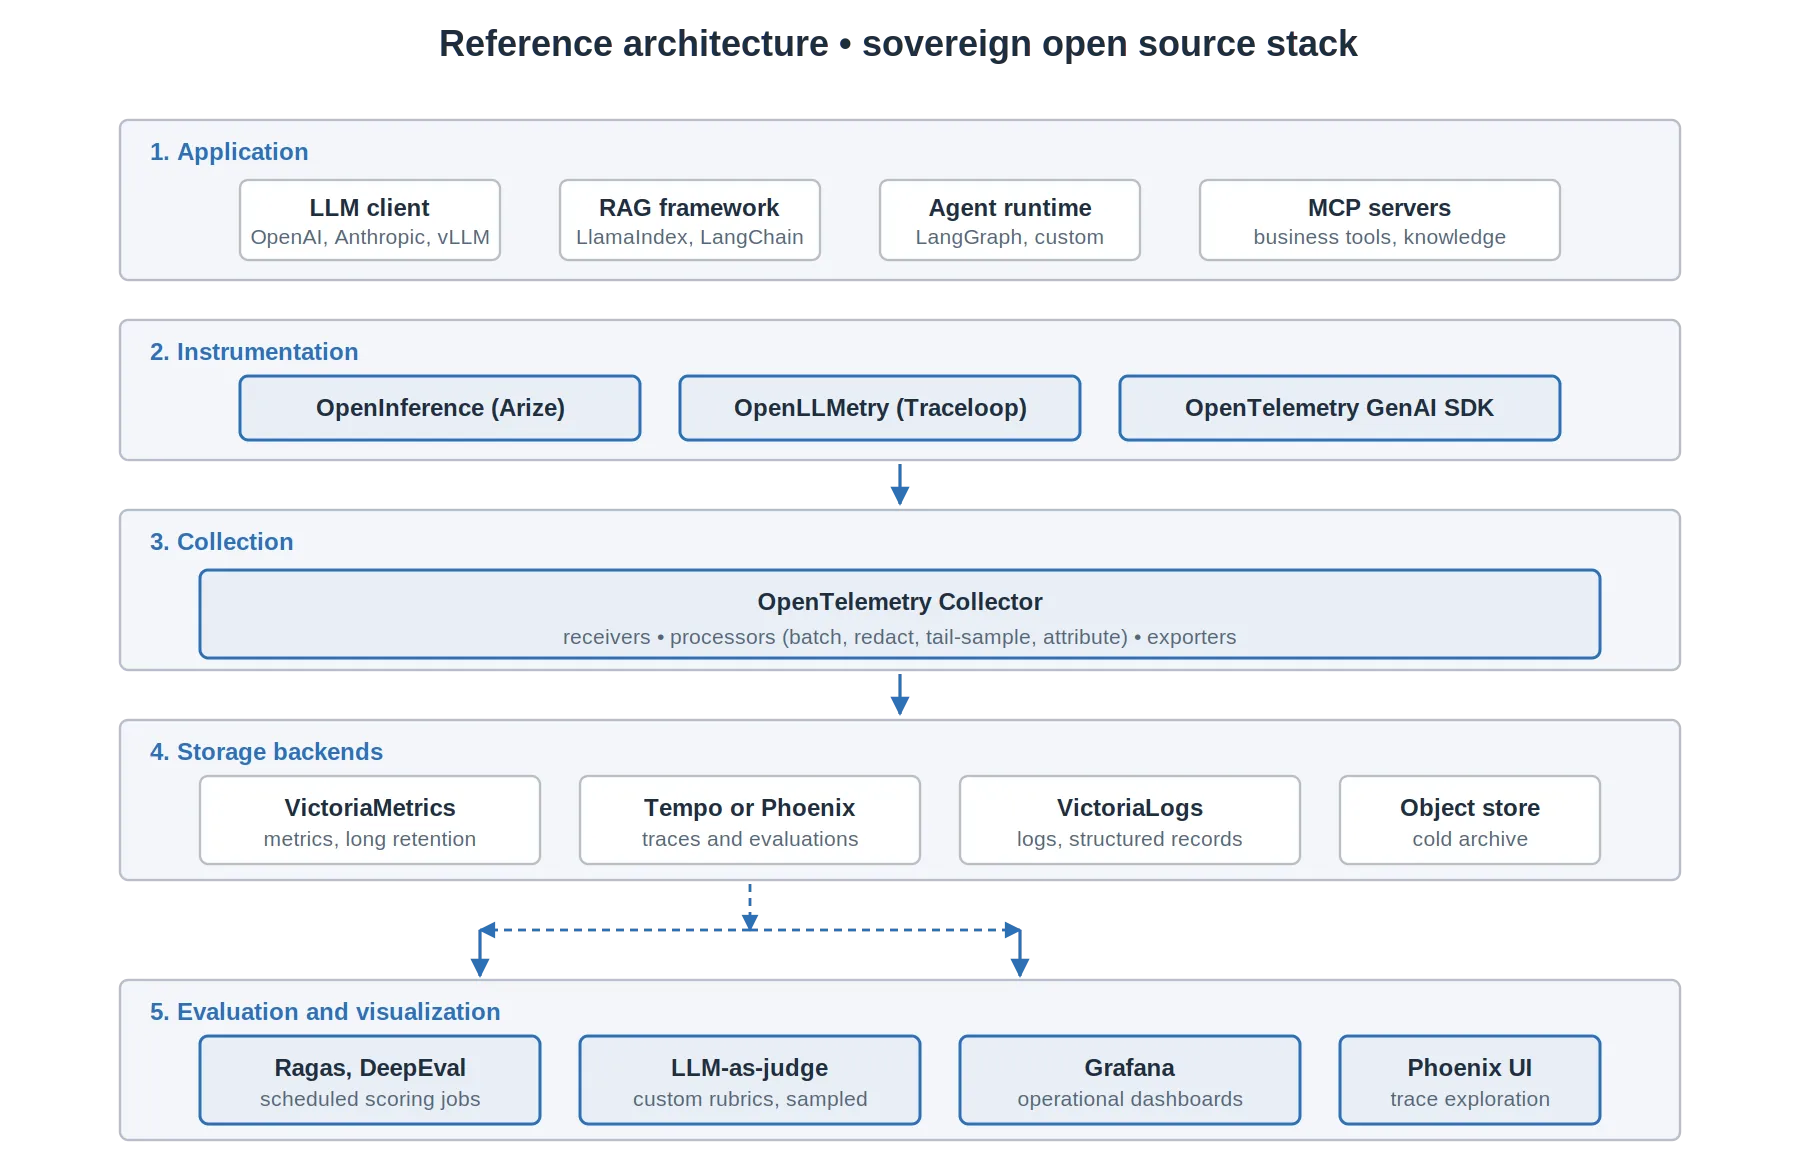
La figure, issue de la première version de ce guide, porte le titre « open source stack ». Phoenix, qui y figure, est pourtant sous licence source disponible (Elastic License 2.0), voir ci-dessus.
Figure 9. Architecture de référence d’une stack auto-hébergée. Chaque couche est remplaçable indépendamment. L’OpenTelemetry Collector est le point d’intégration : il découple l’instrumentation des backends.
Critères de choix des composants
Section intitulée « Critères de choix des composants »Pour les métriques, la figure retient VictoriaMetrics. Il est à envisager si vos métriques d’IA ont une forte cardinalité et que vous voulez un binaire unique avec une longue rétention. L’éditeur annonce une meilleure tenue de la cardinalité que Prometheus ; mesurez-la sur votre charge. Alternatives : Prometheus avec un stockage distant, Thanos ou Grafana Mimir.
Pour les traces et l’évaluation propres à l’IA, Phoenix réunit dans un seul outil une interface de traces et d’évaluation, ce qui réduit le travail d’intégration. Sa licence est source disponible (ELv2), à faire valider. L’alternative open source est Langfuse (MIT pour le cœur).
Pour les traces généralistes, Tempo assure le traçage distribué des services hors IA. Il est utile quand la plateforme mêle services traditionnels et fonctionnalités d’IA. Alternatives : Jaeger, SigNoz.
Pour les journaux, VictoriaLogs est un binaire unique qui s’exploite comme VictoriaMetrics, avec son propre langage de requête (LogsQL), distinct de MetricsQL. Alternatives : Grafana Loki, OpenObserve, Elasticsearch.
Pour l’instrumentation, la figure retient OpenInference. C’est un arbitrage, pas une recommandation sans condition. OpenInference couvre de nombreux cadres LLM, exporte en OTLP et constitue la convention native de Phoenix. Mais il utilise ses propres attributs (openinference.span.kind, llm.*) et non les attributs gen_ai.* des conventions OpenTelemetry, que ce guide prend pour référence. Deux voies cohérentes existent. La première : OpenInference si Phoenix est votre outil d’exploration principal et que vous acceptez sa convention, en convertissant au besoin vers gen_ai.* avec le processeur transform du Collector pour les autres backends. La seconde : les instrumentations OpenTelemetry GenAI natives (ou OpenLLMetry), qui émettent gen_ai.*, si vous privilégiez une convention unique et portable entre outils, au prix de conventions encore en développement. Dans les deux cas, une seule convention doit alimenter les tableaux de bord et les alertes.
Pour l’évaluation RAG, Ragas est un cadre Python dédié aux métriques RAG. Comparez-le avec DeepEval ou Phoenix evals selon les métriques dont vous avez besoin.
Pour la visualisation, Grafana sert de couche opérationnelle. L’interface de l’outil de traces IA prend en charge l’exploration propre à l’IA.
6.3 Une stack en service géré
Section intitulée « 6.3 Une stack en service géré »Pour les organisations sans contrainte de localisation et déjà équipées d’un éditeur d’observabilité commercial, quatre configurations reviennent souvent.
Si vous êtes déjà chez un éditeur généraliste (Datadog, New Relic ou équivalent), activez son module d’observabilité LLM. Vous gardez une seule facture et une seule interface ; vérifiez la couverture des évaluateurs et le coût au volume.
Si la qualité et l’évaluation sont prioritaires, regardez une plateforme spécialisée comme Arize AX ou Braintrust, ou Langfuse Cloud. Comparez-les sur les évaluateurs fournis, la possibilité d’écrire les vôtres et l’export des données.
Si l’évaluation prime et que le traçage est secondaire, Galileo, Patronus AI ou Braintrust sont des candidats.
Si la gestion des prompts est le besoin central, regardez Langfuse Cloud, PromptLayer ou Vellum.
6.4 Licences des briques
Section intitulée « 6.4 Licences des briques »Cette section est la référence du site sur les licences ; les autres contenus y renvoient. « Open source » recouvre des régimes très différents. Est open source au sens de l’OSI (l’Open Source Initiative, qui tient la définition de référence) une licence qui autorise notamment tout usage, y compris commercial. Certaines licences dites « source disponible » laissent lire le code mais restreignent son usage : elles n’en font pas partie. La confusion se paie au moment de l’industrialisation. Les licences changent : vérifiez celle de la version que vous déployez.
| Brique | Rôle | Licence | Point de vigilance |
|---|---|---|---|
| OpenTelemetry Collector | passerelle | Apache-2.0 | aucun |
| Jaeger | traces | Apache-2.0 | aucun |
| Prometheus | métriques | Apache-2.0 | aucun |
| VictoriaMetrics | métriques | Apache-2.0 (édition communautaire, version cluster comprise) | sous-échantillonnage (downsampling), rétentions multiples et détection d’anomalies réservés à l’édition entreprise |
| ClickHouse | stockage en colonnes | Apache-2.0 | aucun |
| OpenLIT, OpenLLMetry | instrumentation | Apache-2.0 | aucun |
| Ragas, DeepEval | évaluation | Apache-2.0 | coût des appels au juge |
| Grafana, Tempo, Loki | visualisation, traces, journaux | AGPL-3.0 | obligations en cas de redistribution et aussi quand une version modifiée est mise à disposition d’utilisateurs par le réseau |
| Langfuse | observabilité LLM | MIT pour le cœur | certaines fonctions sous licence commerciale ; racheté par ClickHouse le 16 janvier 2026 |
| Arize Phoenix | observabilité LLM | Elastic License 2.0 (source disponible) | pas open source au sens de l’OSI : interdit de proposer le logiciel comme service géré à des tiers |
| Elasticsearch | journaux | code source des fonctions gratuites au choix sous AGPL v3, SSPL ou ELv2 | distributions binaires officielles sous ELv2 |
Deux régimes posent problème en revue juridique.
La licence Elastic 2.0 interdit de proposer le produit comme service géré à des tiers. C’est sans effet pour un usage interne, mais bloquant pour un éditeur qui embarque la brique dans son offre.
L’AGPL de Grafana, Tempo et Loki n’est en général pas un obstacle pour un déploiement interne non modifié. Elle s’applique en revanche à la redistribution et à l’interaction par le réseau avec une version modifiée. Concrètement, modifier Grafana et l’ouvrir à des utilisateurs, même sans le distribuer, oblige à leur proposer le code source modifié. Signalez-le avant que quelqu’un ne construise un produit par-dessus.
Pour choisir la brique propre aux LLM, appliquez les mêmes trois critères à toutes les options : la licence (open source au sens de l’OSI ou source disponible), la possibilité d’auto-héberger et la capacité à recevoir de l’OTLP avec les conventions gen_ai.* sans SDK propriétaire. L’article de mise en production applique ces critères à sa propre stack.
Mon conseil pour démarrer : partez de ce que vous exploitez déjà, posez le Collector devant, puis ajoutez un seul outil propre à l’IA après avoir vérifié sa licence.
Suite : 7. Exploiter la plateforme.
Révisé le 2 octobre 2026 : prix retirés, retrait de Humanloop (fermé), rachats de Langfuse et de Traceloop, WhyLabs passé en open source, licences de Phoenix et d’Elasticsearch précisées, colonnes du tableau rendues neutres, exigences de localisation de NIS2 et DORA corrigées.
Révisé le 4 octobre 2026 : chapitre désigné comme référence du site pour les outils et les licences, section 6.4 sur les licences par brique (reprise de l’article de mise en production), choix d’OpenInference présenté comme un arbitrage avec les conventions gen_ai.*.
Révisé le 25 octobre 2026 : ouverture sur un scénario illustratif, modes d’hébergement et licences expliqués, critères de choix des composants et configurations gérées rédigés en prose.