

TechniquePratique11 min de lecture
7. Exploiter la plateforme
Faire vivre une plateforme d'observabilité de l'IA : échantillonnage, modélisation des coûts, maîtrise de la cardinalité, données personnelles et souveraineté, sécurité et répartition des responsabilités.
Pour : ingénieurs et SRE · architectes · managers d’équipePrérequis : Avoir lu les chapitres 4 et 5 du guide.
Scénario illustratif. Trois mois après la mise en place de la plateforme, la mutuelle reçoit deux mauvaises surprises la même semaine. La facture de stockage des traces a doublé. Et un audit interne découvre qu’un adhérent a collé son IBAN dans une question : il est désormais lisible par toute l’équipe dans l’outil de traces.
La mise en œuvre n’était qu’un début. Faire vivre une plateforme d’observabilité de l’IA demande des choix délibérés : quelles données garder, combien cela coûte, comment les protéger et qui s’en occupe.
7.1 Stratégie d’échantillonnage
Section intitulée « 7.1 Stratégie d’échantillonnage »Tracer intégralement chaque requête LLM coûte cher en stockage et en traitement. Au-delà de quelques centaines de requêtes par seconde, il faut échantillonner, c’est-à-dire ne garder qu’une partie des traces.
Il y a deux façons de décider lesquelles. L’échantillonnage en tête (head sampling) décide au début de la requête, au hasard, comme un contrôleur qui tire au sort les voyageurs à l’entrée du train. L’échantillonnage en queue (tail sampling) attend la fin de la requête pour décider selon des règles, comme un contrôleur qui ne garde que les billets litigieux une fois le trajet terminé. Le second est plus coûteux en mémoire, mais il permet de garder à coup sûr les traces intéressantes.
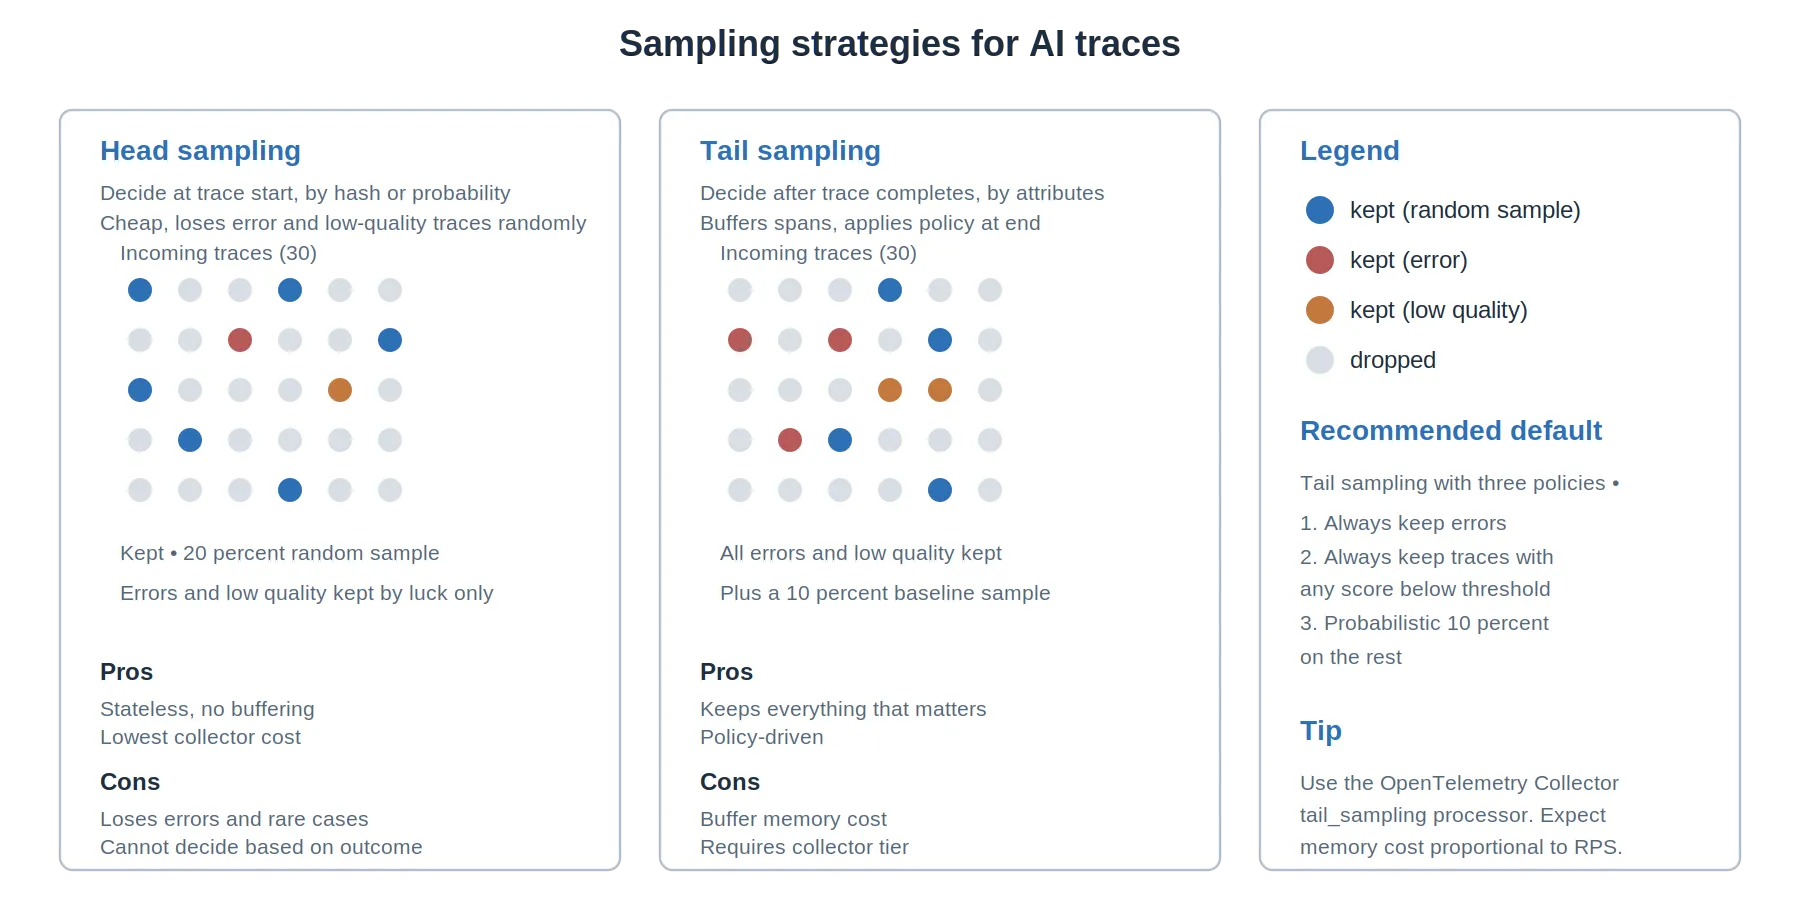
La figure simplifie : seuls les scores d’évaluations synchrones sont disponibles au moment de la décision d’échantillonnage (voir ci-dessous).
Figure 10. L’échantillonnage en tête (head sampling) décide au début de la trace, de façon aléatoire. L’échantillonnage en queue (tail sampling) décide à la fin de la trace, selon des règles. L’échantillonnage en queue conserve de façon déterministe les erreurs, les traces lentes et celles qu’une évaluation synchrone a signalées.
Politique recommandée
Section intitulée « Politique recommandée »Je recommande de toujours conserver les traces en erreur, les traces anormalement lentes et celles dont une évaluation synchrone est sous le seuil. Une évaluation synchrone est faite pendant la requête, comme un filtre de toxicité ou un classifieur de refus. Pour le reste, gardez 10 % des traces au hasard, afin de conserver une vision de référence du trafic normal.
Une limite est à connaître. Le processeur ne peut décider que sur ce que contient la trace quand son délai d’attente expire : erreurs, latences, attributs posés pendant la requête. Les scores des évaluateurs asynchrones et les retours des utilisateurs arrivent bien après, ils ne peuvent donc pas piloter cette décision. Pour conserver les traces notées après coup, gardez toutes les traces brutes sur une rétention courte (quelques jours). Promouvez ensuite vers le stockage long celles qu’un évaluateur a mal notées ou qui ont reçu un retour négatif.
Pour les équipes techniques : le processeur tail_sampling et son dimensionnement
La mise en œuvre passe par le processeur tail_sampling de l’OpenTelemetry Collector. Son délai d’attente est decision_wait, 30 secondes par défaut.
Le coût mémoire du processeur dépend du nombre de traces gardées en attente (num_traces) et de la durée de decision_wait, multipliés par la taille moyenne d’une trace : dimensionnez ces deux paramètres d’après votre débit.
7.2 Modélisation des coûts
Section intitulée « 7.2 Modélisation des coûts »Cette section est la référence du site sur le coût de l’observabilité elle-même. Le coût de la non-observabilité (l’exposition économique d’un système mal observé, avec son calculateur) est traité dans la méthode GenAI, partie V.
À grande échelle, le coût de l’observabilité de l’IA peut rivaliser avec celui des appels LLM eux-mêmes. Il se décompose en trois postes : le stockage, le traitement (le Collector et l’ingestion) et le juge, qui consomme des jetons à chaque évaluation.
Prenons un exemple chiffré. À 100 requêtes par seconde, avec une charge utile moyenne de 4 Ko et 30 jours de rétention chaude, on conserve environ 988,8 Go, soit près d’1 To. Ce volume se multiplie par un prix au Go-mois : c’est un coût mensuel. Côté juge, avec 10 % des requêtes évaluées et 1 500 jetons par jugement, on obtient 864 000 jugements par jour, soit 1 296 millions de jetons par jour pour un seul évaluateur. Le détail du calcul est dans la partie repliée.
Les prix changent vite et varient selon les contrats, ce guide n’en donne donc pas : utilisez la grille datée de votre fournisseur pour cost_per_GB_month et cost_per_token. Comparez les deux postes sur la même période. Le stockage se facture au mois alors que le juge consomme chaque jour (environ 39 milliards de jetons sur 30 jours dans cet exemple). Un tarif unique par jeton est aussi une simplification, car les jetons de sortie sont en général facturés plus cher que les jetons d’entrée.
Pour les équipes techniques : le modèle de coût et le calcul de l'exemple
total_obs_cost  = storage_cost + processing_cost + judge_cost
stored_GB       = RPS * avg_payload_KB * 86400 * retention_days / 1024 / 1024storage_cost    = stored_GB * cost_per_GB_month          (par mois)processing_cost = collector_cost + ingestion_costjudge_cost      = RPS * 86400 * sample_rate * tokens_per_judge * cost_per_token   (par jour)
Exemple à 100 RPS, charge utile moyenne de 4 Ko, rétention chaude de 30 jours : stored_GB = 100 * 4 * 86400 * 30 / 1024 / 1024 = 988,8 Go, soit environ 1 To conservé en stockage chaud storage_cost = 988,8 * cost_per_GB_month (par mois)
Exemple de juge à 100 RPS, échantillon de 10 %, 1 500 jetons par jugement : jugements = 100 * 86400 * 0,10 = 864 000 jugements par jour jetons juge = 864 000 * 1500 = 1 296 millions de jetons par jour pour un seul évaluateur judge_cost = 1 296 000 000 * cost_per_token (par jour)Postes de coût, par ordre d’importance
Section intitulée « Postes de coût, par ordre d’importance »Le premier poste est la taille des charges utiles. Prompts, complétions et contextes récupérés peuvent peser chacun des dizaines de kilo-octets et le volume de stockage croît avec le trafic, proportionnellement.
Le deuxième est l’évaluation par LLM juge, qui consomme des jetons à chaque jugement. Un évaluateur trivial exécuté sur chaque trace peut doubler la consommation totale de jetons.
Le troisième vient des attributs à forte cardinalité, comme user_id, request_id ou session_id. Attachés aux métriques plutôt qu’aux traces, ils font gonfler le stockage des métriques (section 7.3).
Stratégies d’atténuation
Section intitulée « Stratégies d’atténuation »- Compresser et hiérarchiser le stockage des anciennes traces : chaud pendant sept jours, tiède pendant trente, archivage froid au-delà.
- Utiliser de petits modèles pour l’évaluation en ligne et réserver les grands modèles à des lots d’audit périodiques.
- Réserver les attributs à forte cardinalité aux traces et garder des métriques à faible cardinalité par agrégation.
- Échantillonner les exécutions de LLM juge plutôt que d’évaluer chaque trace.
- Hiérarchiser les évaluateurs par coût et réserver les plus chers à un petit échantillon et aux traces signalées.
7.3 Maîtrise de la cardinalité
Section intitulée « 7.3 Maîtrise de la cardinalité »Une métrique se stocke comme un tableau dont chaque ligne est une combinaison de valeurs de ses étiquettes. Avec un modèle et trois fonctionnalités, on a trois lignes. Ajoutez l’identifiant de l’utilisateur et vous avez une ligne par utilisateur et par fonctionnalité : des centaines de milliers. Ce nombre de combinaisons s’appelle la cardinalité. C’est le premier risque de passage à l’échelle d’une plateforme d’observabilité de l’IA, car les charges d’IA ont naturellement des dimensions à forte cardinalité : versions de prompt, versions de modèle, versions d’index de recherche, identifiants de locataire, identifiants d’utilisateur.
Règles empiriques
Section intitulée « Règles empiriques »Les attributs qui prennent des milliers de valeurs distinctes par jour vont sur les traces, pas sur les métriques. Les dimensions des métriques doivent rester bornées : model_name (quelques dizaines de valeurs), feature (quelques dizaines), tenant (quelques centaines au plus). Les métriques par utilisateur sont un anti-modèle : interrogez plutôt les traces par user_id.
Changer de backend ne règle pas le problème. Certains backends (VictoriaMetrics, Grafana Mimir, Thanos, ou les offres gérées) annoncent une meilleure tenue de la forte cardinalité que Prometheus seul ; ce sont des indications des éditeurs, à mesurer sur votre charge. La vraie réponse reste de corriger la conception des métriques.
7.4 Données personnelles et souveraineté
Section intitulée « 7.4 Données personnelles et souveraineté »Les prompts et les complétions contiennent souvent des données personnelles, comme l’IBAN de notre scénario. Trois contrôles sont recommandés, a fortiori en contexte régulé : caviarder avant de stocker, contrôler l’accès, limiter la conservation.
Caviardage avant stockage
Section intitulée « Caviardage avant stockage »Caviarder, c’est noircir les passages sensibles avant archivage, comme on le fait sur un document administratif. Il existe trois techniques, de la plus simple à la plus coûteuse.
Les expressions régulières repèrent les motifs connus : e-mail, téléphone, IBAN, carte bancaire, numéros de sécurité sociale. Le processeur redaction du Collector le fait (valeurs bloquées masquées ou hachées, clés non autorisées supprimées).
La reconnaissance d’entités nommées (NER, named entity recognition) repère les noms de personnes, d’organisations et de lieux, que les motifs ne savent pas décrire. Le Collector ne le fait pas nativement. Il faut un service externe, par exemple un moteur de détection de données personnelles appelé par l’application ou par un composant intermédiaire, ou un processeur personnalisé.
Un LLM peut enfin nettoyer ce qui dépend du contexte, là où expressions régulières et NER échouent. Même contrainte : il faut un composant externe, avec son coût et sa latence.
Faites le caviardage par expressions régulières dans le collecteur, avant l’export. Placez les traitements NER ou LLM en amont du stockage. Jamais dans le backend de stockage, une fois les données écrites.
Contrôle d’accès
Section intitulée « Contrôle d’accès »Le minimum est un contrôle d’accès fondé sur les rôles (RBAC, role-based access control) sur les requêtes de traces : chacun voit ce que son rôle autorise. Quand le backend le permet, ajoutez un contrôle au niveau des champs : les clés d’attributs restent lisibles par tous, mais le corps des prompts et des complétions exige des droits élevés. Tenez enfin un journal d’audit de tous les accès aux traces, conservé selon les exigences réglementaires.
Politique de rétention
Section intitulée « Politique de rétention »La durée de conservation s’aligne sur le principe de limitation de la conservation (article 5, paragraphe 1, point e) du RGPD) et sur les réglementations sectorielles. Prévoyez une rétention distincte pour les métadonnées de traces (plus longue) et pour leur contenu (plus courte). Automatisez les purges et faites-les vérifier par audit.
7.5 Sécurité
Section intitulée « 7.5 Sécurité »L’observabilité des LLM ouvre une surface d’attaque que l’APM classique (la supervision de la performance des applications) ne connaît pas. La plateforme d’observabilité devient elle-même un coffre qui contient une copie des conversations.
Les prompts stockés peuvent contenir des secrets collés par erreur par les utilisateurs : clés d’API, jetons d’authentification, mots de passe. Les complétions stockées peuvent contenir des données d’entraînement que le modèle a mémorisées et restituées. Les chaînes d’évaluation qui appellent des LLM juges externes peuvent faire sortir des données sensibles vers des fournisseurs tiers. Les interfaces de requête de traces montrent le contenu intégral des interactions passées à toute personne qui y a accès. Enfin, une injection de prompt peut viser le modèle juge lui-même et fausser les scores des évaluateurs.
Mesures d’atténuation
Section intitulée « Mesures d’atténuation »- Nettoyer avant stockage les motifs de secrets, en plus des données personnelles.
- Refuser par défaut les appels sortants vers des LLM juges, avec une liste explicite de fournisseurs autorisés.
- Contrôler les flux réseau sortants du collecteur vers les points d’accès des juges.
- Tenir un journal d’audit de tous les accès aux traces et le relire périodiquement.
- Chiffrer le stockage des traces, au repos et en transit.
- Durcir les prompts de juge contre l’injection : assainir les champs d’entrée, utiliser des délimiteurs, ne jamais placer le contenu évalué dans le prompt système.
7.6 Répartition des responsabilités
Section intitulée « 7.6 Répartition des responsabilités »Une plateforme sans propriétaire se dégrade vite. Je recommande un partage simple. L’équipe plateforme porte la stack : collecteurs, backends, tableaux de bord, routage des alertes. L’équipe ML porte les évaluateurs, les seuils de qualité et le jeu de non-régression. L’équipe sécurité porte le caviardage, les politiques d’accès et la revue d’audit.
Les trois équipes tiennent ensemble la revue hebdomadaire des traces en échec et à faible score. C’est à mon avis l’instance récurrente la plus utile et la seule qui ferme la boucle.
La matrice RACI complète (produit, conformité et astreinte qualité compris) est dans la méthode GenAI, partie VII, qui fait référence ; l’AI Act et la preuve réglementaire sont dans la partie VI.
Pour commencer cette semaine, vérifiez deux choses : où sont caviardées vos données avant stockage et qui peut lire le contenu des prompts aujourd’hui.
Suite : 8. Versionnage, rejeu et expérimentation.
Révisé le 2 octobre 2026 : prix retirés, limites de l’échantillonnage en queue (évaluations asynchrones et retours utilisateurs), dimensionnement mémoire, caviardage NER et LLM hors du Collector, article 5 du RGPD, exigences de localisation de NIS2 et DORA corrigées.
Révisé le 4 octobre 2026 : section 7.2 désignée comme référence sur le coût de l’observabilité, avec renvoi à la méthode pour le coût de la non-observabilité ; section 7.6 résumée en trois lignes avec renvoi au RACI de la méthode.
Révisé le 25 octobre 2026 : ouverture sur un scénario illustratif, échantillonnage, cardinalité et caviardage expliqués par des images, modèle de coût et paramètres du processeur placés dans des parties repliables, listes rédigées en prose.