

TechniquePratique9 min de lecture
2. Périmètre et typologie des systèmes d'IA
Les quatre types de systèmes d'IA (LLM seul, RAG, agents, outils MCP), ce qu'il faut capturer pour chacun, leurs défaillances caractéristiques et la forme de leurs traces.
Pour : ingénieurs et SRE · architectesPrérequis : Avoir lu le chapitre 1 du guide.
Dans le scénario illustratif de la mutuelle, l’assistant a commencé simple : une question, un appel au modèle, une réponse. Puis l’équipe lui a donné accès aux conditions générales pour qu’il réponde à partir des textes. Ensuite, elle l’a autorisé à consulter le dossier de l’adhérent via un outil. À chaque étape, le système a changé de nature et les pannes possibles aussi.
L’observabilité de l’IA couvre quatre types de systèmes qui se recouvrent. Chacun demande sa propre instrumentation et a ses défaillances typiques. La même stack d’observabilité doit gérer les quatre, parce que les applications réelles les combinent librement. Un agent en production fait en général de la recherche documentaire et appelle des outils MCP : une seule requête mobilise alors trois des quatre types.
Cette typologie est la référence pour tous les contenus du site sur l’observabilité de l’IA générative. Les labs, l’article de mise en production et la méthode GenAI s’y rattachent. Le ML classique et la vision sortent de ce périmètre : voir Au-delà du LLM : GPU et qualité des modèles.
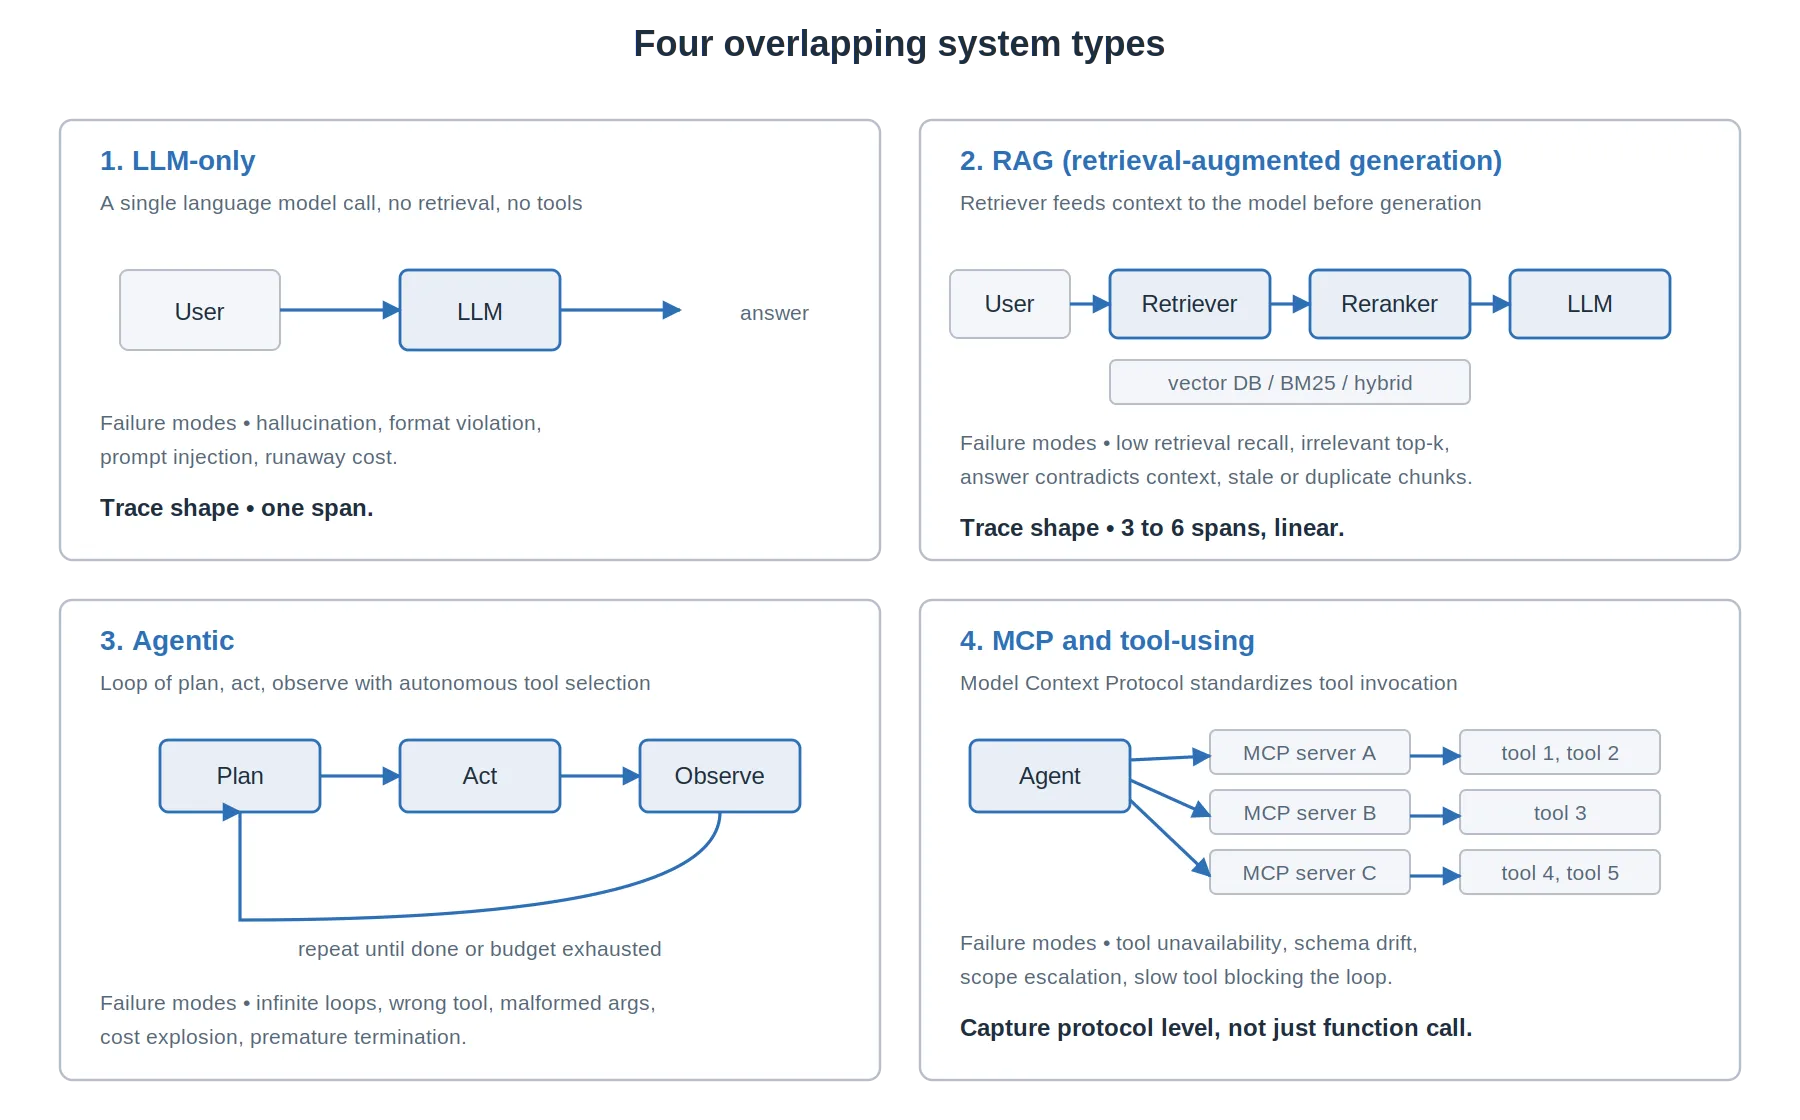
Figure 3. Les quatre types de systèmes. Les modes de défaillance sont donnés à titre d’illustration et ne sont pas exhaustifs.
2.1 Systèmes LLM seuls
Section intitulée « 2.1 Systèmes LLM seuls »C’est un appel unique à un modèle de langage, sans recherche documentaire ni outil. On envoie un texte, on reçoit un texte. C’est le cas le plus simple et souvent le premier qui part en production.
Ce qu’il faut capturer
Section intitulée « Ce qu’il faut capturer »- Le prompt, avec le prompt système (les consignes fixes données par l’application) et le prompt utilisateur (la question posée) dans des champs séparés.
- La réponse, avec
finish_reason, la raison pour laquelle le modèle s’est arrêté :stop(fin normale),length(limite de longueur atteinte),content_filter(réponse filtrée),tool_call(le modèle demande un outil),error, dans le vocabulaire des conventions OpenTelemetry. - La consommation de jetons, en entrée et en sortie. Distinguez les jetons mis en cache quand le fournisseur les expose.
- La latence de bout en bout et, si la réponse arrive en flux (streaming), le délai jusqu’au premier jeton : c’est lui que l’utilisateur ressent.
- L’identité du modèle, y compris la version réellement servie, souvent différente du nom demandé.
- Les paramètres d’échantillonnage, qui règlent la part de hasard dans la réponse : température, top-p, top-k, graine (seed) si elle est fixée.
Défaillances caractéristiques
Section intitulée « Défaillances caractéristiques »Le modèle peut inventer des entités, des dates ou des citations. Il peut ne pas respecter le format attendu : l’application voulait du JSON, elle reçoit de la prose. Un utilisateur peut glisser dans sa question des instructions qui détournent le modèle de ses consignes, c’est l’injection de prompt. Les coûts peuvent déraper quand la longueur de la réponse n’est pas plafonnée. Enfin, le fournisseur peut tomber en panne ou changer de modèle sans prévenir.
2.2 Chaînes RAG
Section intitulée « 2.2 Chaînes RAG »La génération augmentée par recherche (retrieval-augmented generation, RAG) fonctionne comme un étudiant qui a droit à ses notes pendant l’examen. Avant de répondre, on cherche les passages utiles dans une base documentaire, puis on les donne au modèle avec la question. La recherche peut se faire par le sens dans une base vectorielle (qui stocke les plongements), par mots-clés avec un algorithme comme BM25, ou en combinant les deux.
L’observabilité doit alors capturer aussi l’étape de recherche et le lien entre les passages retrouvés et la réponse produite. La recherche ouvre une seconde source de pannes : le modèle peut être parfait et répondre mal parce qu’on lui a donné les mauvais documents. C’est ce qui est arrivé à l’assistant de la mutuelle, qui lisait une ancienne version du contrat.
Ce qu’il faut capturer en plus du cas LLM seul
Section intitulée « Ce qu’il faut capturer en plus du cas LLM seul »- La requête de recherche, qui est souvent une reformulation de la question de l’utilisateur.
- Les fragments (chunks) retrouvés, c’est-à-dire les morceaux de documents, avec leurs identifiants, leurs documents sources et leurs scores de similarité.
- Le nombre de fragments retenus (le top-k, les k meilleurs) et les filtres appliqués : date, source, locataire. Un locataire (tenant) est un client ou une entité qui partage la même plateforme que les autres.
- L’étape de reclassement (reranking), où un second modèle remet les fragments dans l’ordre de pertinence : identité du modèle, fragments en entrée, ordre en sortie.
- Les identifiants des fragments présents dans le prompt final, pour relier chaque fragment à la réponse qui l’a utilisé.
Dimensions de qualité
Section intitulée « Dimensions de qualité »Quatre questions résument la qualité d’un RAG. La précision du contexte (context precision) mesure la part des fragments retrouvés qui sont pertinents. Le rappel du contexte (context recall) mesure la part des fragments pertinents qui ont bien été retrouvés. La fidélité vérifie que la réponse s’appuie sur le contexte retrouvé, que ce contexte soit juste ou non. La pertinence de la réponse (answer relevancy) vérifie qu’elle traite la question posée.
Défaillances caractéristiques
Section intitulée « Défaillances caractéristiques »Avec un rappel faible, le document pertinent n’a jamais été retrouvé et le modèle invente une réponse plausible. Avec un top-k non pertinent, les scores de similarité étaient élevés mais les fragments ne répondaient pas vraiment à la question. Il y a contradiction quand la réponse contredit le contexte retrouvé, c’est un défaut de fidélité. Les fragments périmés viennent d’un index qui n’a pas été mis à jour après un changement. Les fragments dupliqués, enfin, répètent le même contenu et biaisent la réponse.
2.3 Systèmes agentiques
Section intitulée « 2.3 Systèmes agentiques »Un agent travaille comme un stagiaire à qui on confie une tâche : il réfléchit à ce qu’il doit faire, agit, regarde le résultat, puis recommence jusqu’à estimer avoir fini. C’est la boucle planifier, agir, observer. L’observabilité doit capturer la structure de cette boucle et le raisonnement à chaque tour.
Les agents sont le type de système le plus difficile à observer, parce que certaines de leurs pannes n’ont pas de limite naturelle : ils peuvent tourner en rond, faire exploser les coûts ou s’arrêter trop tôt.
Ce qu’il faut capturer en plus du cas LLM seul
Section intitulée « Ce qu’il faut capturer en plus du cas LLM seul »- Le raisonnement du planificateur à chaque étape, quand le modèle l’expose. Pour les modèles de raisonnement, la chaîne de pensée (le raisonnement intermédiaire écrit par le modèle) est elle-même un attribut de span.
- Les appels d’outils avec leur nom, leurs arguments et la réponse reçue.
- Le nombre d’itérations et la raison de la fin de boucle : succès, budget épuisé, nombre maximal d’itérations atteint, erreur.
- Le coût et la latence par étape, avec les cumuls sur toute la trace.
- Les appels d’outils répétés avec des arguments identiques, qui signalent en général une boucle.
Défaillances caractéristiques
Section intitulée « Défaillances caractéristiques »La plus visible est la boucle infinie ou presque, que seul arrête le nombre maximal d’itérations ou le budget. L’agent peut aussi choisir le mauvais outil quand plusieurs outils ont des descriptions qui se recouvrent. Il peut fournir des arguments mal formés : mauvais types, champs obligatoires manquants, valeurs inventées pour une liste fermée. Il peut s’arrêter trop tôt et répondre sans avoir terminé la tâche. Et les coûts explosent quand le contexte grossit à chaque tour de boucle.
2.4 MCP et systèmes à outils
Section intitulée « 2.4 MCP et systèmes à outils »Le Model Context Protocol (MCP) joue pour les outils le rôle qu’une prise standard joue pour les appareils électriques. Il normalise la façon dont un modèle de langage appelle des outils, quel que soit le fournisseur. Un serveur MCP expose un ou plusieurs outils (consulter un dossier, chercher une facture), que les agents peuvent découvrir et appeler.
Quand des serveurs MCP font partie du système, l’observabilité doit capturer le niveau du protocole, pas seulement l’appel de fonction. Un serveur MCP peut en effet devenir un goulet d’étranglement partagé entre plusieurs agents et applications.
Ce qu’il faut capturer
Section intitulée « Ce qu’il faut capturer »- L’identité et la version du serveur MCP.
- Le nom de l’outil, ses arguments et la réponse reçue.
- La latence et le taux d’erreur par outil et par serveur.
- La portée d’authentification de chaque appel, c’est-à-dire le jeton ou l’identité transmis et les droits qu’il donne.
- Les événements de découverte : le moment où l’agent a demandé pour la première fois la liste des outils disponibles.
- Le choix entre serveurs quand plusieurs serveurs MCP sont connectés.
Défaillances caractéristiques
Section intitulée « Défaillances caractéristiques »L’outil peut être indisponible, parce que le serveur MCP est arrêté ou lent. Le schéma peut dériver entre serveur et client quand le serveur publie une nouvelle signature d’outil. Il y a élévation de portée quand un agent utilise un outil qui exige plus de droits que n’en a l’utilisateur. Un outil lent peut bloquer toute la boucle de l’agent : un seul outil avec un délai d’expiration de 30 secondes peut peser plus lourd que tout le reste de la trace. Enfin, avec l’empoisonnement d’outil (tool poisoning), le serveur MCP renvoie une sortie forgée pour manipuler l’agent.
2.5 La forme de la trace dépend du type de système
Section intitulée « 2.5 La forme de la trace dépend du type de système »La même bibliothèque de spans produit des arbres de traces très différents selon le type de système. La figure 4 montre la trace réaliste d’un agent RAG qui combine les quatre types : un span racine, une boucle d’agent, deux appels LLM, deux étapes de recherche, un appel d’outil MCP et trois spans d’évaluation rattachés après la génération.
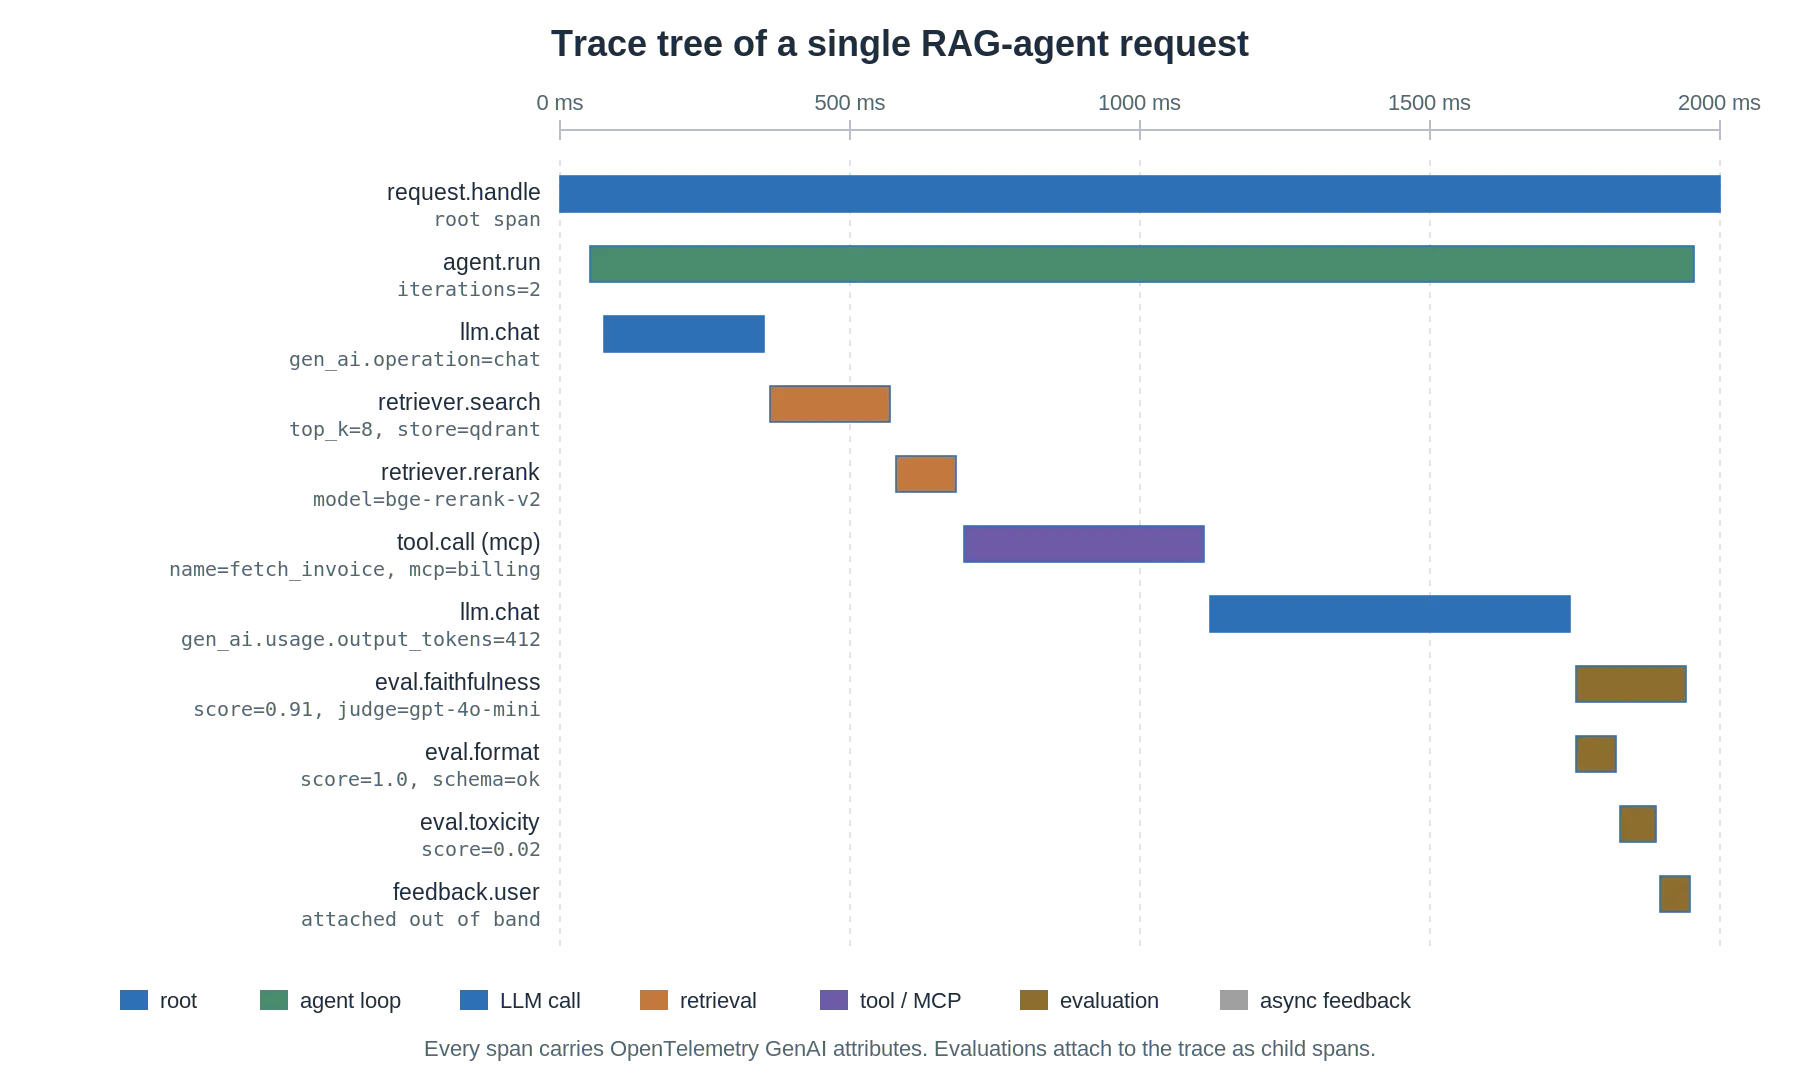
Figure 4. Arbre de trace d’une requête d’agent RAG. La même trace contient les quatre types de systèmes : appels LLM, recherche documentaire, boucle d’agent et outil MCP. Les évaluations s’y rattachent comme spans enfants.
Trois choses se lisent sur cette forme. Les évaluations vivent dans la même trace que la requête qu’elles notent : ce ne sont pas des journaux à part. Les retours qui arrivent plus tard, comme le pouce baissé d’un utilisateur, sont rattachés après coup mais retrouvés par l’identifiant de trace. Enfin, la largeur des barres donne la latence de chaque étape. La barre la plus large est le poste dominant, c’est elle que je vous conseille d’optimiser en premier.
Suite : 3. La feuille de route de maturité.
Révisé le 4 octobre 2026 : typologie en quatre types présentée comme la référence du site, périmètre (ML classique et vision exclus) rappelé.
Révisé le 25 octobre 2026 : ouverture sur le scénario illustratif, chaque type introduit par une image, termes techniques expliqués (top-k, reclassement, locataire, BM25, chaîne de pensée), défaillances rédigées en prose.