

TechniquePratique12 min de lecture (+2 technique)
4. La mise en œuvre en sept étapes
Sept étapes ordonnées pour amener un système d'IA du niveau 0 à une plateforme de niveau 3 opérationnelle : questions, instrumentation, collecte, stockage, évaluation, visualisation et boucle fermée.
Pour : ingénieurs et SRE · architectesPrérequis : Avoir lu les chapitres 1 à 3 du guide ; notions de base sur OpenTelemetry.
Scénario illustratif. Six mois après le lancement, la direction de la mutuelle pose une question simple : combien coûte l’assistant pour chaque caisse régionale et ses réponses sont-elles aussi bonnes partout ? L’équipe a pourtant instrumenté abondamment. Des centaines d’attributs par span, des tableaux de bord pleins de courbes. Mais personne n’avait pensé à enregistrer la caisse régionale sur chaque requête. La question reste sans réponse.
Ce chapitre décrit sept étapes ordonnées pour amener un système du niveau 0 à une plateforme de niveau 3 qui fonctionne. L’ordre compte. Sauter des étapes donne une stack qui émet des données que personne n’interroge.
Étape 1 : définir d’abord les questions
Section intitulée « Étape 1 : définir d’abord les questions »Avant toute instrumentation, écrivez les questions auxquelles la plateforme doit répondre. C’est comme préparer une enquête : on rédige le questionnaire avant d’aller sur le terrain, sinon on revient avec des réponses à des questions que personne n’a posées. La stratégie d’instrumentation découle des questions, pas l’inverse.
L’échec typique est celui du scénario : on instrumente tout, puis on s’aperçoit que les attributs nécessaires pour répondre aux vraies questions n’ont jamais été capturés. Ce sont souvent des attributs à forte cardinalité, c’est-à-dire qui prennent beaucoup de valeurs différentes (un identifiant de client, de caisse, de session).
Je range les questions en trois familles. Voici des exemples pour chacune.
Questions opérationnelles
Section intitulée « Questions opérationnelles »- Quelle est la latence p95 et p99 de chaque étape de la chaîne, par locataire ? (Le p95 est la durée sous laquelle passent 95 % des requêtes : il montre ce que vivent les utilisateurs les moins bien servis.)
- Quelle fonctionnalité a consommé le plus de jetons la semaine dernière et comment cela se compare-t-il à la semaine précédente ?
- À quelle fréquence l’agent entre-t-il dans une boucle de plus de dix étapes et quels outils sont en cause ?
- Quel est le taux d’erreur de chaque serveur MCP et un serveur domine-t-il à lui seul la latence globale ?
Questions de qualité
Section intitulée « Questions de qualité »- Quel est le score de fidélité des réponses ancrées dans le corpus documentaire Z ?
- Quelle est la tendance des signalements de toxicité sur les 30 derniers jours ?
- Quelles versions de prompt ont produit des régressions sur le jeu de référence ?
- Existe-t-il une dérive de la distribution des langues en entrée corrélée à des baisses de qualité ?
Questions d’investigation
Section intitulée « Questions d’investigation »- Montrez-moi le prompt et la réponse complets de la requête soumise par l’utilisateur X à l’instant T (ce qui suppose une capture du contenu activée explicitement, avec un accès contrôlé : voir l’étape 2).
- Montrez-moi toutes les traces dont la sortie contenait un motif de numéro de carte bancaire.
- Montrez-moi toutes les traces qui ont appelé l’outil
billing.invoice_fetchavec des arguments contenant l’identifiant de locataire Y.
Fixez-vous un objectif interne de délai pour répondre aux questions d’investigation, par exemple moins d’une minute. Aucune réglementation n’impose ce chiffre, il est illustratif. Mais pendant un incident ou face à un auditeur, la rapidité d’investigation devient une fonctionnalité à part entière.
Étape 2 : instrumenter
Section intitulée « Étape 2 : instrumenter »Instrumenter, c’est poser des capteurs dans le code pour qu’il raconte ce qu’il fait. Je vois trois options, par ordre de préférence.
La première est l’instrumentation OpenTelemetry GenAI native, quand elle existe. Les SDK sont encore en cours de maturation mais leur adoption est, à mon avis, le bon pari à long terme.
La deuxième passe par des bibliothèques d’auto-instrumentation comme OpenInference (Arize) ou OpenLLMetry (Traceloop). Elles enveloppent les bibliothèques clientes courantes (SDK OpenAI, SDK Anthropic, LangChain, LlamaIndex) et émettent les spans automatiquement, sans que vous ayez à modifier chaque appel.
La troisième consiste à créer les spans à la main autour de la logique métier propre à votre application, celle qu’aucun cadre connu ne couvre.
Pour chaque appel LLM, capturez au minimum le nom du modèle, les jetons en entrée et en sortie, la latence et le statut d’erreur. Le prompt et la complétion suivent la règle de capture du contenu expliquée plus bas. D’autres attributs sont utiles : température, top-p, empreinte (hash) du prompt système, définitions d’outils, identifiant de requête, identifiant de locataire, version du prompt, version du moteur de recherche. Une empreinte est un code calculé à partir d’un texte : deux textes identiques donnent la même empreinte, ce qui permet de repérer un changement sans stocker le texte.
Conventions sémantiques OpenTelemetry GenAI : le noyau
Section intitulée « Conventions sémantiques OpenTelemetry GenAI : le noyau »Les conventions GenAI fixent le nom des attributs pour que tous les outils parlent la même langue : le modèle demandé s’appelle partout gen_ai.request.model, les jetons en entrée gen_ai.usage.input_tokens. Le tableau du noyau et les détails de version sont dans la partie repliée ci-dessous.
Ces conventions sont encore au statut « en développement ». Elles sont maintenues depuis juin 2026 dans un dépôt dédié et plusieurs attributs ont déjà été renommés (par exemple gen_ai.system, nom qu’utilisait la première version de ce guide, devenu gen_ai.provider.name). La liste complète des attributs, leurs versions et l’historique des renommages sont tenus à jour dans l’article de mise en production, section 2 : c’est la référence du site sur ce point.
Pour les équipes techniques : le tableau des attributs du noyau
| Attribut | Type | Rôle |
|---|---|---|
gen_ai.operation.name | string | Type d’opération (chat, embeddings, retrieval, execute_tool, invoke_agent, etc.) |
gen_ai.provider.name | string | Identité du fournisseur (openai, anthropic, mistral_ai, etc.) |
gen_ai.request.model | string | Nom du modèle demandé |
gen_ai.response.model | string | Modèle réellement utilisé (peut différer de la demande) |
gen_ai.usage.input_tokens | int | Nombre de jetons en entrée |
gen_ai.usage.output_tokens | int | Nombre de jetons en sortie |
gen_ai.response.finish_reasons | string[] | Raison de fin de génération (stop, length, content_filter, tool_call, error) |
gen_ai.input.messages, gen_ai.output.messages | structuré, opt-in | Contenu du prompt et de la complétion (voir la règle de capture ci-dessous) |
Capture du contenu des prompts et des réponses
Section intitulée « Capture du contenu des prompts et des réponses »Les prompts et les réponses contiennent souvent des données personnelles : le nom de l’adhérent, son numéro de contrat, parfois sa santé. D’où une seule règle sur le site : la capture du contenu est désactivée par défaut et ne s’active qu’explicitement (opt-in).
C’est aussi ce que prévoient les conventions. gen_ai.input.messages, gen_ai.output.messages et gen_ai.system_instructions sont au niveau d’exigence « Opt-In » et les instrumentations ne doivent pas les capturer par défaut. Pour la production, la spécification recommande de stocker le contenu hors des traces, avec ses propres contrôles d’accès et de ne garder que des références sur les spans. L’enregistrement dans les attributs des spans convient plutôt à la préproduction, ou aux cas où le stockage des traces respecte les règles de confidentialité. Quand le contenu transite malgré tout par les traces, il est masqué dans le Collector avant stockage (étape 3). Les drapeaux d’activation, les événements et les règles du Collector sont détaillés dans l’article de mise en production (spécification).
Vos attributs personnalisés doivent porter un préfixe propre à votre organisation, pour ne jamais entrer en collision avec de futures conventions. Exemple : acme.tenant_id, acme.prompt_version, acme.retriever.index_name.
Pour les équipes techniques : exemple de span manuel pour une recherche RAG
Ce pseudo-code enregistre par défaut la longueur et l’empreinte de la requête, jamais son texte. Le texte n’est ajouté, sous forme d’événement, que si la capture du contenu a été activée.
# Pseudo-code Python avec opentelemetry.trace et hashlib# CAPTURE_CONTENT : drapeau de configuration, False par défautdef search(rewritten_query, tenant_id): with tracer.start_as_current_span("retriever.search") as span: span.set_attribute("acme.retriever.store", "qdrant") span.set_attribute("acme.retriever.top_k", 8) # Par défaut : longueur et condensat de la requête, jamais le texte span.set_attribute("acme.retriever.query_length", len(rewritten_query)) span.set_attribute("acme.retriever.query_sha256", hashlib.sha256(rewritten_query.encode()).hexdigest()) if CAPTURE_CONTENT: # opt-in explicite, désactivé par défaut # texte en événement, hors des attributs indexés, masqué dans le Collector span.add_event("acme.retriever.query", {"text": rewritten_query}) span.set_attribute("acme.tenant_id", tenant_id) span.set_attribute("acme.retriever.index_name", "kb-prod-v3") chunks = vector_store.search(rewritten_query, k=8) span.set_attribute("acme.retriever.hits", len(chunks)) if chunks: span.set_attribute("acme.retriever.top_score", chunks[0].score) span.add_event("chunks", {"ids": [c.id for c in chunks]}) return chunksÉtape 3 : collecter
Section intitulée « Étape 3 : collecter »Placez un OpenTelemetry Collector entre l’application et le backend (la base qui stocke les données). Le Collector joue le rôle d’un centre de tri postal : il reçoit tous les envois, les trie, retire ce qui ne doit pas partir et expédie le reste vers les bonnes destinations.
Il prend en charge ce qui n’a pas sa place dans l’application : mise en lots, nouvelles tentatives en cas d’échec, contre-pression (ralentir l’envoi quand le stockage sature), enrichissement d’attributs, filtrage, échantillonnage, caviardage (redaction, le masquage des données sensibles) et envoi vers plusieurs backends à la fois.
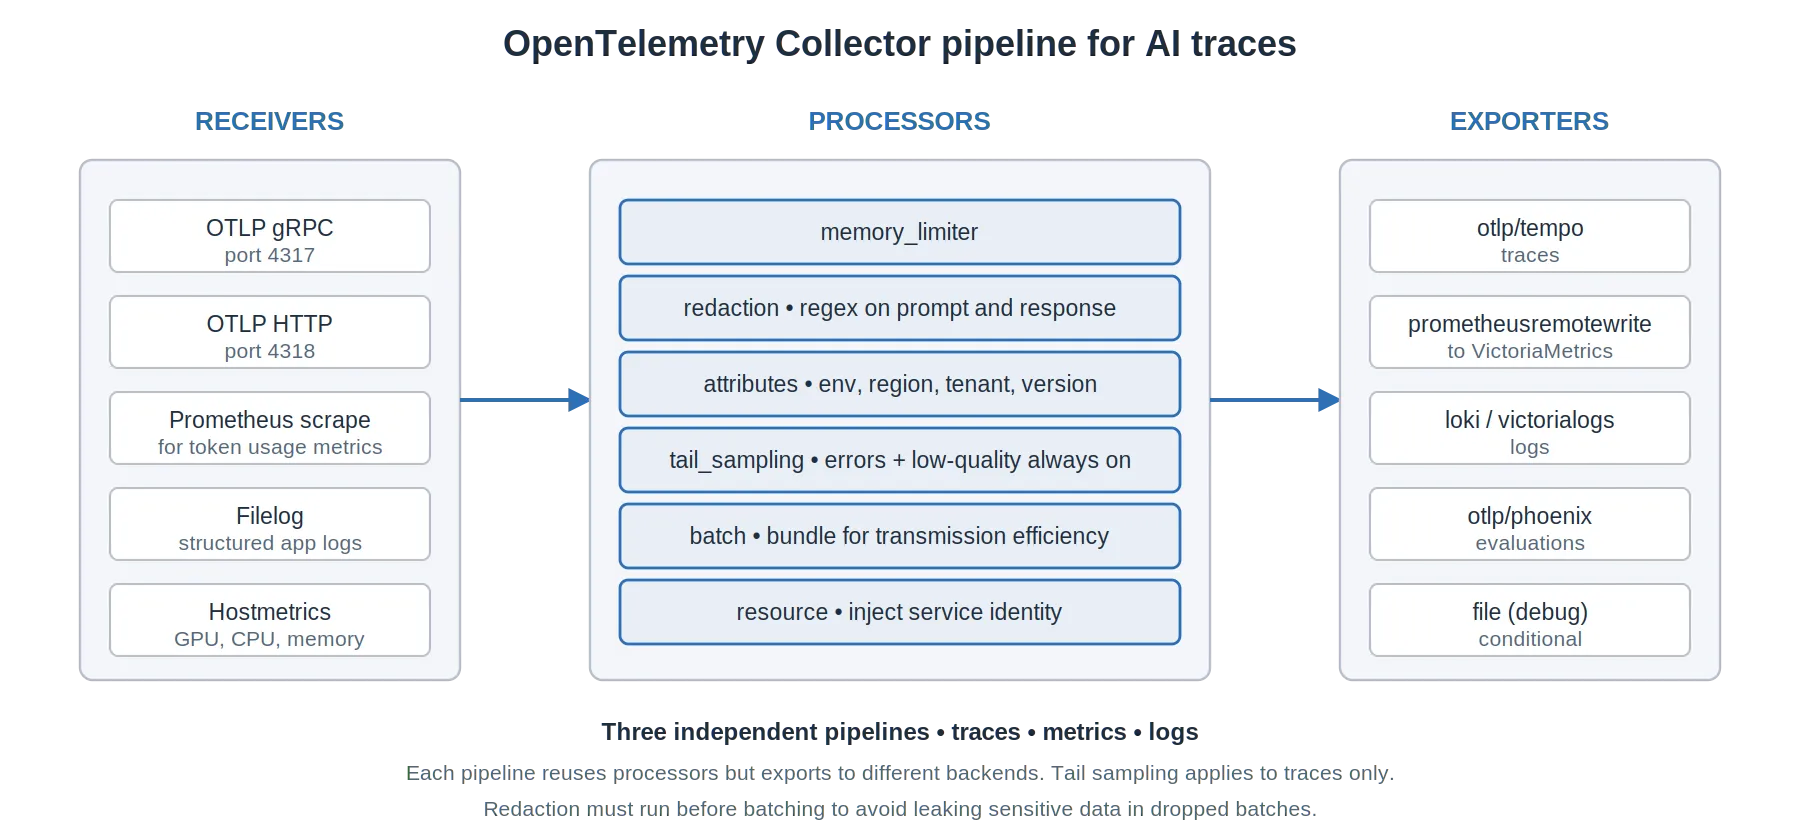
Figure 7. Pipeline de l’OpenTelemetry Collector. Les récepteurs ingèrent les données, les processeurs les transforment, les exportateurs les acheminent vers les backends. Trois pipelines tournent en parallèle pour les traces, les métriques et les journaux.
Processeurs essentiels pour les traces d’IA
Section intitulée « Processeurs essentiels pour les traces d’IA »Six processeurs font l’essentiel du travail. L’un protège le Collector des débordements de mémoire, un autre caviarde, deux enrichissent les spans, un échantillonne et le dernier regroupe avant l’envoi. Leur rôle précis est dans la partie repliée.
Pour les équipes techniques : les six processeurs et leurs paramètres
memory_limiter: protège le collecteur d’un dépassement mémoire lors des pics de trafic.redaction: nettoyage des attributs avant stockage. Il supprime les attributs absents d’une liste de clés autorisées (allowed_keys), puis masque ou hache les valeurs qui correspondent à des expressions régulières bloquées (blocked_values). Il ne fait pas de reconnaissance d’entités nommées (NER) : celle-ci, comme le caviardage par LLM, exige un composant externe ou un processeur personnalisé (documentation du processeur).attributes: injecte de façon uniforme l’environnement, la région, le locataire et la version de déploiement.tail_sampling: décision fondée sur des règles, prise une fois la trace terminée.batch: regroupe les spans pour une transmission efficace. Se place en dernier dans la chaîne des processeurs.resource: injecte l’identité et la version du service dans chaque span.
Étape 4 : stocker
Section intitulée « Étape 4 : stocker »Chaque type de signal a son propre stockage, comme une bibliothèque range séparément livres, revues et archives tout en gardant un catalogue commun. Ici, le catalogue commun est l’identifiant de trace : une stack cohérente choisit un backend par signal et s’assure qu’ils partagent cet identifiant, pour pouvoir passer de l’un à l’autre.
| Signal | Logiciels auto-hébergeables | Services gérés (SaaS) |
|---|---|---|
| Métriques | Grafana Mimir, Prometheus, Thanos, VictoriaMetrics | Chronosphere, Datadog, Grafana Cloud, New Relic |
| Traces | Grafana Tempo, Jaeger, Phoenix (licence ELv2, source disponible), SigNoz | Arize AX, Datadog APM, Grafana Cloud, Honeycomb |
| Journaux | Elasticsearch, Grafana Loki, OpenObserve, VictoriaLogs | Datadog, Elastic Cloud, Grafana Cloud, Splunk |
| Évaluations | Rattachées aux traces, agrégées en métriques | Idem : c’est une convention, pas un produit |
| Retours utilisateurs | Magasin d’événements indexé par identifiant de trace | Idem : développement spécifique |
| Archive froide | Stockage objet compatible S3 | S3, Azure Blob, GCS |
Les options sont listées par ordre alphabétique ; le chapitre 6 précise les licences et les critères de choix. Trois contraintes guident le choix du stockage : la durée de conservation, la rapidité des requêtes sur des prompts volumineux et les exigences de localisation des données. Quand une exigence de localisation s’applique (politique interne, régulateur sectoriel ou contrat), c’est souvent elle qui détermine la stack.
Étape 5 : évaluer
Section intitulée « Étape 5 : évaluer »L’évaluation en ligne peut se déclencher de deux façons.
En mode synchrone (inline), chaque requête déclenche une évaluation avant que la réponse ne parte. Cela ajoute de la latence. Je réserve ce mode aux cas où le résultat doit décider de la réponse, par exemple un filtre de toxicité ou un classifieur de refus : si le contenu est jugé dangereux, la réponse n’est pas envoyée.
En mode asynchrone, une tâche de fond prélève des traces et les évalue hors du chemin de la requête. L’utilisateur n’attend pas. C’est le mode par défaut.
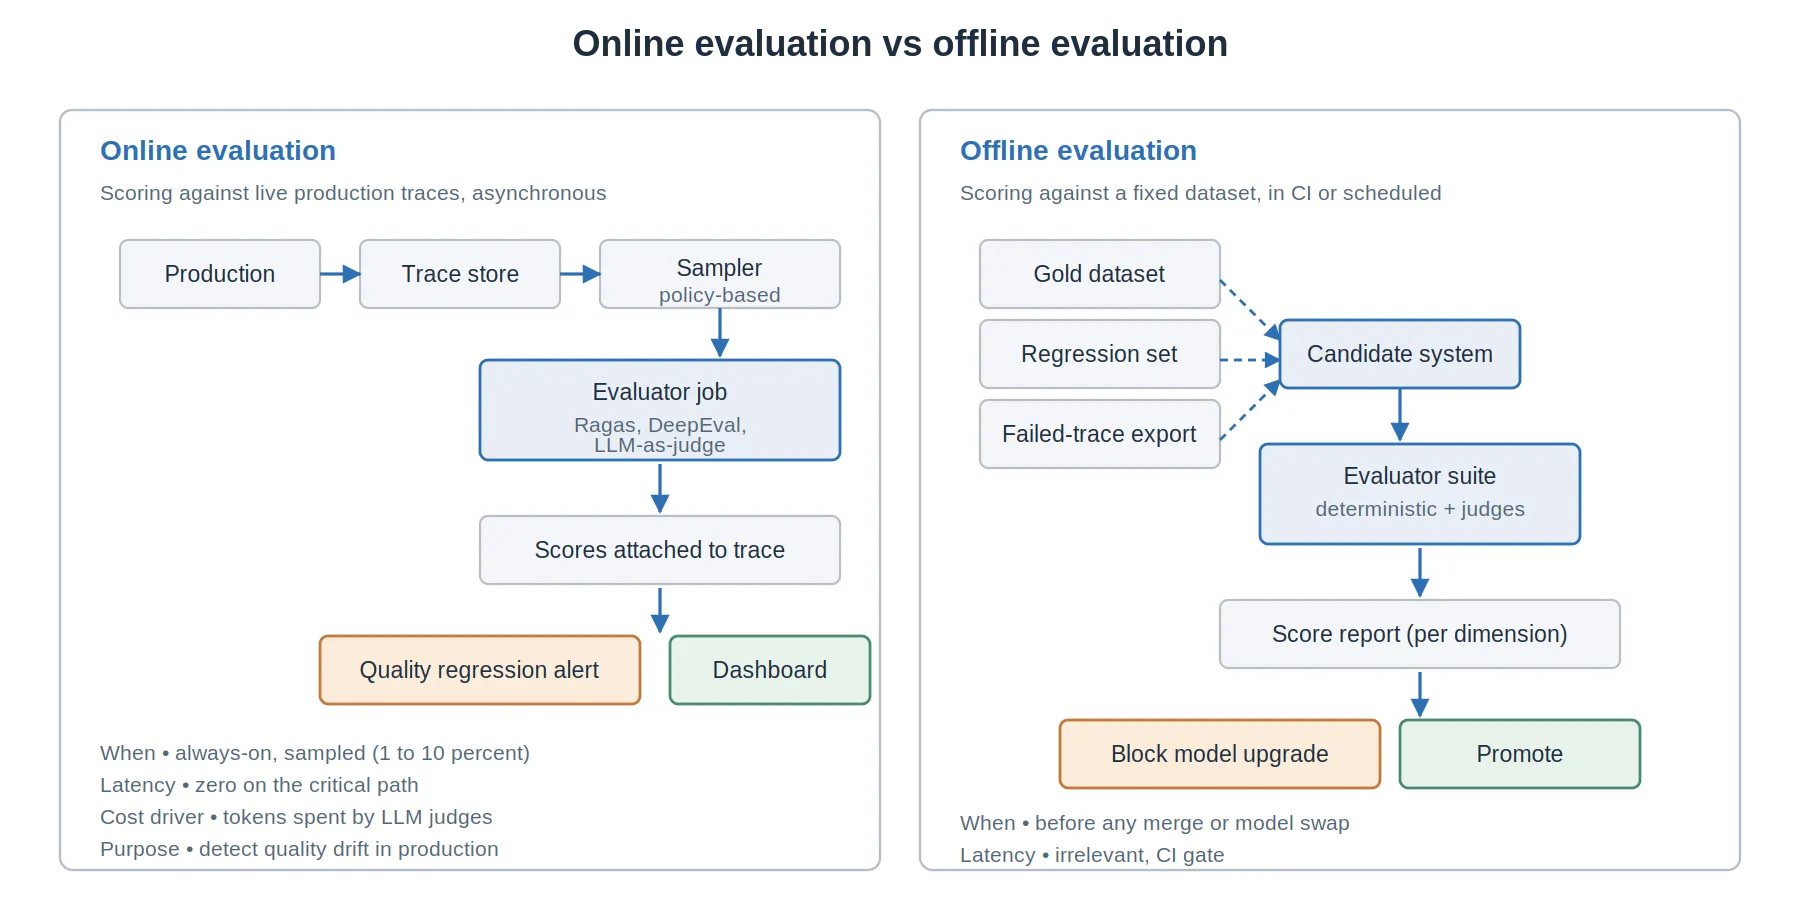
Figure 8. L’évaluation en ligne s’exécute sur les traces de production en direct. L’évaluation hors ligne s’exécute sur des jeux de données figés, en intégration continue ou en lots planifiés. Les deux sont nécessaires : l’une pour détecter la dérive, l’autre pour bloquer les régressions.
Le chapitre 5 détaille la conception des évaluateurs : modèles de prompts pour LLM juge, calibration et agrégation des scores.
Étape 6 : visualiser et alerter
Section intitulée « Étape 6 : visualiser et alerter »Construisez des tableaux de bord qui répondent aux questions de l’étape 1, pas des tableaux qui montrent tout ce qui est disponible. Regroupez-les par public et par préoccupation : la finance ne regarde pas les mêmes courbes que l’équipe d’astreinte.
Familles de tableaux de bord
Section intitulée « Familles de tableaux de bord »- Coût et usage : jetons par fonctionnalité, par locataire, par modèle, avec des bandes d’anomalie.
- Latence et fiabilité : p50, p95, p99 par étape de la chaîne, taux d’erreur par mode de défaillance.
- Qualité et sûreté : scores des évaluateurs dans le temps, avec alertes de régression sur les baisses de qualité.
- Dérive et distribution : longueur des entrées, langue, distribution des sujets et dérive des plongements.
- Comportement des agents : histogrammes d’itérations, fréquence de sélection des outils, indicateurs de boucle.
Conditions d’alerte
Section intitulée « Conditions d’alerte »Un tableau de bord sert au diagnostic, une alerte réveille quelqu’un. Les conditions ci-dessous sont des exemples ; un SLO (service level objective) est un objectif chiffré de service, comme « 95 % des réponses en moins de deux secondes ».
- Régression de qualité au-delà d’un seuil (par exemple, une baisse de la fidélité de plus de deux écarts-types).
- Pic de coût au-delà d’un multiple de référence (par exemple, des jetons par minute supérieurs à 3 fois la médiane glissante sur sept jours).
- Dégradation de latence (p95 au-dessus du SLO pendant plus de cinq minutes).
- Détection de données personnelles ou d’identifiants secrets dans les sorties (tout compte non nul sur une fenêtre d’une minute).
- Indicateur de boucle d’agent (plus de dix itérations dans une trace, seuil cohérent avec la question de l’étape 1, ou un nombre d’itérations supérieur au plafond défini pour la fonctionnalité).
Étape 7 : fermer la boucle
Section intitulée « Étape 7 : fermer la boucle »Sans revue régulière, les données s’accumulent et rien ne s’améliore. Je recommande un rendez-vous hebdomadaire, court, avec quatre sujets.
On passe en revue les traces en échec et celles qui ont un faible score, puis on verse les plus parlantes dans le jeu de non-régression. On regarde aussi les traces au score élevé pour en tirer des exemples à inclure dans les prompts (few-shot). On vérifie que tout changement de modèle ou de prompt passe le jeu de non-régression : aucune fusion si un score d’évaluateur régresse. Enfin, on examine la tendance des retours utilisateurs et on en tire des actions sur la recherche documentaire, les prompts ou le choix du modèle.
C’est cette boucle qui distingue une plateforme d’observabilité d’un système de journalisation. Sans elle, vous disposez d’une archive coûteuse en lecture seule.
Pour lundi matin, l’étape 1 suffit. Réunissez pendant une heure la plateforme, le produit et un représentant métier. Écrivez ensemble vos premières questions.
Suite : 5. Conception des évaluateurs.
Révisé le 2 octobre 2026 : conventions GenAI déplacées dans le dépôt semantic-conventions-genai (v1.42.0), historique des attributs de contenu et valeurs de finish_reasons corrigés, fonctionnement réel du processeur redaction, place du processeur batch et batching côté exportateur, colonnes du tableau de stockage rendues neutres.
Révisé le 4 octobre 2026 : tableau des conventions réduit au noyau, historique des renommages remplacé par un renvoi à l’article de mise en production, règle de capture du contenu alignée sur la spécification (désactivée par défaut, activation explicite, stockage à part recommandé en production).
Révisé le 25 octobre 2026 : ouverture sur un scénario illustratif, termes expliqués (cardinalité, p95, empreinte, caviardage, SLO), tableau des attributs, exemple de code et liste des processeurs placés dans des parties repliables.